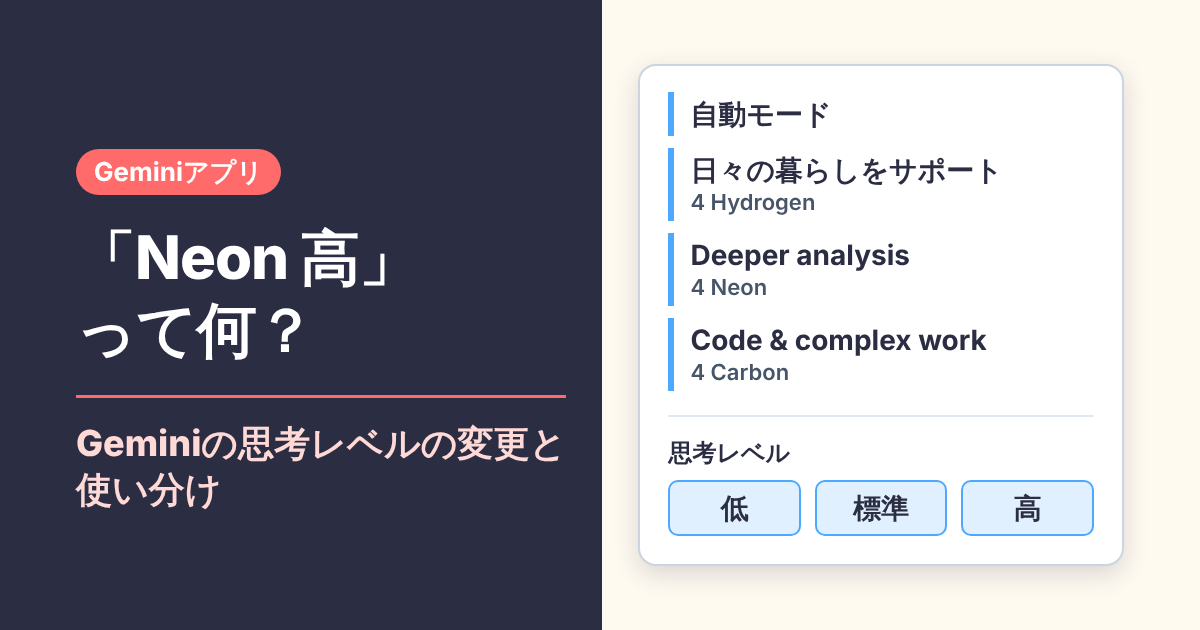
Geminiのアプリを開くと、モデルの呼び名と思考レベル(答える前にどれだけ考えるかの設定)に、また変更が入っていました。メニューの上には「Neon 高」の文字が出ています。
気になるのは、前と何が変わったのか。速さと値段と正確さはどうなのか。そして、自分の使い方ならどの設定にすればいいのか、の3つです。ChatGPTとClaudeが公表している数字とも並べてみます。目次のすぐ下には、約1分40秒の解説動画も置きました。
Geminiの思考レベルの変更
約1分40秒の解説動画
ぼくが作った、約1分40秒の解説動画です。新しいメニューの並びと、思考レベルの選び方を先に見たい方は、こちらをどうぞ。
メニューの新しい並び
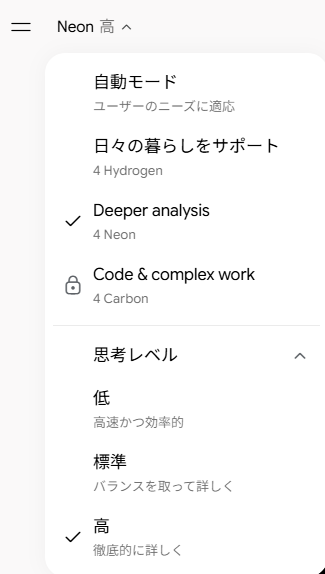
画面のメニューには、上から「自動モード」「日々の暮らしをサポート」「Deeper analysis」(より深い分析)「Code & complex work」(コードや複雑な作業)の4つが並んでいます。モデルの名前は、それぞれの下に小さく添えてあります。「4 Hydrogen」「4 Neon」「4 Carbon」(ハイドロジェン・ネオン・カーボン)は、Googleが9月末から11月にかけて順に出してきた「Gemini 4」というシリーズのモデルです。
Googleの説明では、メニューの並びの順に、それぞれ次のような位置づけです。
- 自動モード:質問ごとにHydrogenか速くて軽いモデルを選び、思考レベルも合わせて決めます。
- Hydrogen:日常の作業向けの、速くて効率のよいモデルです。
- Neon:HydrogenとCarbonの中間にあたり、深さと効率のバランスをとったモデルです。
- Carbon:いちばん強く、難しい長丁場の問題向けのモデルです。
メニューの上に出ている「Neon 高」は、チェックが付いているモデル(Deeper analysisの欄のNeon)と、チェックが付いている思考レベル(高)を、続けて書いた表示と読めます。
なし
(無料)
出てきた順番も並べておきます。日付は米国時間で、日本ではこの翌日です。同じシリーズのArgon(アルゴン)が9月30日に発表され(一般提供は10月13日)、Carbonは10月28日の発表(一般提供は11月10日)、Hydrogenが11月12日、Neonが11月18日でした。
前の呼び名との対応
Googleの日本語のヘルプには、まだ前の表が載っています(11月19日の時点)。同じヘルプの英語版は中身が変わっていて、並べるとこうなります。
| プラン | 日本語のヘルプの表 | 英語のヘルプの表 |
|---|---|---|
| Google AIプランなし | 自動モード、またはFlash-Lite | 自動モードのみ |
| Google AI Plus | Flash-Lite・Hydrogen | 自動モード・Hydrogen |
| Google AI Pro | Flash-Lite・Hydrogen・Pro・Argon | 自動モード・Hydrogen・Neon |
| Google AI Ultra | Flash-Lite・Hydrogen・Argon・Carbon | 自動モード・Hydrogen・Neon・Carbon |
| 思考レベル | 低・中・高 | Low・Medium・High |
出典:Google(Gemini アプリ ヘルプの日本語版と英語版・2026年11月19日に確認)
Argonは、10月13日からProとUltraのアプリで選べました。英語のヘルプの表からは、いまArgonが消えています。API(アプリやプログラムからAIを使うときの窓口)では今も使えます。ITmedia NEWSも11月19日の記事で、ArgonがProのモデル選択からも消えたと伝えています。Neonが後を継いだのか別の役割なのかは、Googleの説明がまだ出ていないので、これからの発表を待つことになりそうです。
Argonが出たときの数字の比べ方は、前に書いた記事にあります。

メニューの鍵のアイコン
Carbonの横には鍵のアイコンがあります。Googleのヘルプによると、鍵がついた上位モデルは、対応するプランへのアップグレードが必要という印です。上限のしるしではなく、プランの条件の印、ということです。英語のヘルプの表では、Neonを選べるのはProとUltra、CarbonはUltraだけです。
名前と役割を一度に覚えるのは大変そうです。ChatGPT・Gemini・Claudeの3つの使い方を1冊で扱ったムックがあります。楽天ブックスで1,210円でした(11月19日時点)。Hydrogenなどの新しい名前までは載っていないかもしれませんが、3つの基本を知る入口にはなりそうです。

思考レベルの低・標準・高
手動で選ぶときだけ
思考レベルを選べるのは、モデルを自分で選んだときだけです。自動モードでは、Geminiが質問ごとに思考レベルも決めます。モデルを選んで思考レベルを選ばなかったときの既定は「低」で、選んだモデルと思考レベルは、その会話のあいだ(あとで同じ会話に戻ったときも)使われます。
画面の説明は、「低」が「高速かつ効率的」、「標準」が「バランスを取って詳しく」、「高」が「徹底的に詳しく」です。Googleのヘルプの英語は、Lowが単純な質問に速く簡潔に答える、Mediumが速さと考える深さのバランス(日常のタスク向け)、Highが複雑で複数の段階がある質問を丁寧に考える、という説明です。「標準」はMediumに当たりそうですが、画面の言葉とヘルプの言葉が同じものかどうかは、Googleが書いていないようです。
APIには、highの上にxhigh(エックスハイ)という段もあります。アプリの画面で選べるのは、低・標準・高の3段までです。Googleは、まずhighから始めて、足りないときだけxhighにするよう助言していて、xhighは遅くなり、トークン(AIが読み書きする文字の量の単位)も多く使い、単純な課題では考えすぎることがある、とも書いています。
使用量の上限
Geminiアプリの上限は、回数ではなく計算量で決まります。質問の複雑さ、使うモデルや機能、会話の長さが関わり、5時間ごとに回復して、週の上限まで使えます。高度なモデルと高い思考レベルは使用量を多く使い、上限に達すると、速くて軽いモデルで会話が続きます。上限の大きさは、Plusが無料の2倍、Proが4倍、UltraがProの5倍または20倍です。
使いやすくなった?
変わった点
- 無料でも、質問に合うときは自動モードがHydrogenを選んで使えます(Googleの発表)。
- 日本語のヘルプの表にはFlash-LiteやProのようなモデルの名前が並んでいますが、いまのメニューは役割の言葉が見出しで、名前はその下に小さく添えてあります。
- 鍵のアイコンで、いまのプランでは選べないモデルが分かります。
- 思考レベルが低・標準・高の3段にそろい、選んだ設定は会話のあいだ続きます。
選ぶ手間は減ったと読めます。ただ、名前が増えたぶん、最初は戸惑う人もいそうです。
分かりにくいという声
分かりにくいという声もあります。AIworkerという会社のnote(11月15日)は、「名前だけ見ても、違いはまず分かりませんよね。」と書き、「毎月のように新しい名前が出てくると、追いかけるだけで疲れますよね。」とも書いています。どれが何の役なのかを先に知っておくと、選びやすくなりそうです。
「Gemini 超活用 完全ガイド」という題名のムックもあります。楽天ブックスで1,100円でした(11月19日時点)。

待ち時間と速さ
ここから先の数字は、アプリの設定ではなく、APIの段で測った値です。アプリの「低・標準・高」がAPIのlow・medium・high・xhighのどれに当たるのかは、Googleの説明からは読み取れません。とくにアプリの「高」は、highなのかxhighなのか決め手がありません。なので、数字はAPIの段のものとして見るのがよさそうです。
測っているのは、Artificial Analysis(AA)です。AIの性能を第三者の立場で測っているサイトで、総合点は、9つのテストを合わせた「Intelligence Index v5.0.1」で出しています。数字はすべて2026年11月19日の値です(※英語サイト・自動翻訳推奨)。
設定を上げると
同じモデルで段を上げていくと、質問を送ってから答えの最初の文字が出るまでの秒数が伸びます。Neonはlowの13.9秒からxhighの56.5秒、Hydrogenはlowの6.4秒からxhighの45.7秒です。Carbonはlowが8.9秒で、highが73.2秒でした。
出典のURLと取得時刻
Googleは、速さを相対的な言葉でも説明しています。APIの表では、Hydrogenが「Fast」、Neonが「Moderate」、Carbonが「Deliberate」です。Hydrogenは、前のGemini 3.8 Flashより、highの設定で2.5倍速くタスクを終えるとしています。
モデルで見ると
費用は、AAのテストの問題1つあたりの平均を、APIの料金で計算した額です。出力速度は1秒に書き出すトークンの数で、最初の回答までは、質問を送ってから答えの最初の文字が出るまでの秒数です。時間は、時計で測った値ではなく、問題1つあたりの出力のトークン数を出力速度で割った計算上の値で、最初の回答までの待ち時間は入っていません。
| モデルとAPIの段 | 総合点 | 問題1つの費用 | 計算上の時間 | 出力速度 | 最初の回答まで |
|---|---|---|---|---|---|
| Hydrogen low | 27 | $0.29 | 1.5分 | 156 | 6.4秒 |
| Hydrogen medium | 41 | $0.80 | 4.2分 | 157 | 14.3秒 |
| Hydrogen high | 51 | $1.87 | 8.6分 | 164 | 19.6秒 |
| Hydrogen xhigh | 54 | $3.16 | 15.3分 | 169 | 45.7秒 |
| Neon low | 44 | $0.75 | 3.7分 | 97 | 13.9秒 |
| Neon medium | 55 | $1.90 | 8.3分 | 101 | 20.1秒 |
| Neon high | 59.6 | $3.74 | 14.8分 | 101 | 40.6秒 |
| Neon xhigh | 61 | $6.44 | 21.5分 | 110 | 56.5秒 |
| Carbon low | 54 | $7.19 | 30.4分 | 47 | 8.9秒 |
| Carbon medium | 58 | $6.59 | 29.6分 | 58 | 32.1秒 |
| Carbon high | 60 | $7.76 | 37.1分 | 55 | 73.2秒 |
出典:Artificial Analysis(Intelligence Index v5.0.1・APIで測定・2026年11月19日取得)。各モデルのページ:Gemini 4 Hydrogen、Gemini 4 Neon、Gemini 4 Carbon(※英語サイト・自動翻訳推奨)
Carbonの費用は、AAが12月1日からの単価(入力$4・出力$20)で計算した値で、Googleの11月30日までの単価($2・$10)とは基準が違います。Neonは発売の翌日に測った値で、AAは6時間ごとに測り直しているので、これから動きそうです。
月額とAPIの単価
アプリの月額
Geminiアプリで選べるモデルは、Google AIのプランで変わります。日本の月額は次のとおりです(Googleのプランのページ、11月19日。税の扱いは、申し込みの画面で確かめてください)。
- Google AI Plus:¥725
- Google AI Pro:¥2,900
- Google AI Ultra:Proの5倍の上限で¥14,500、20倍の上限で¥32,000
APIの単価
アプリやプログラムからAPIで呼ぶと、使った量に応じた料金がかかります。単価は100万トークンあたりで、出力には、考えるために使ったトークンも含まれます。各社の料金ページ(Google、OpenAI、Anthropic。※英語サイト・自動翻訳推奨)に載っている数字で、各社の自己申告です。
| モデル | 入力 | 出力 | 条件 |
|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | 無料枠あり |
| Gemini 4 Neon | $3.00 | $15.00 | 無料枠なし |
| Gemini 4 Carbon | $2.00 → $4.00 | $10.00 → $20.00 | 11月30日まで$2.00・$10.00。12月1日から$4.00・$20.00 |
| Gemini 4 Argon | $2.00 → $4.00 | $10.00 → $20.00 | Carbonと同じ |
| GPT-6.2 Astra | $8.00 | $40.00 | 272Kトークン未満の標準料金 |
| GPT-6.2 Sol | $2.00 | $10.00 | 272Kトークン未満の標準料金 |
| Claude Fable 5.2 | $8 | $40 | ― |
| Claude Opus 5.5 | $4 | $20 | ― |
| Claude Sonnet 5.5 | $2 | $10 | ― |
出典:Google・OpenAI・Anthropic の各料金ページ(2026年11月19日に確認)
CarbonとArgonのAPI単価は、11月30日までは入力$2.00・出力$10.00の導入価格です。12月1日からは入力$4.00・出力$20.00に上がります。
Neonの費用について、Googleは発表のなかで、既定のhighの設定ならCarbonより1課題あたり32%安いと書いています。Googleが自分で出した数字です。
正確さを測ると
正答率のこと
AAが総合点に入れているテストの1つに「AA-Omniscience」があり、正答率が出ています。Hydrogenは46〜51%、Neonは57〜61%、Carbonは49〜58%です(段によって幅があります)。
ハルシネーション率の読み方
AAは、ハルシネーション(AIがもっともらしい間違いを答えること)の率も出しています。定義は、正解でなかった回答のうち、間違いだった割合です。答えなかったり、部分的にしか答えなかったりした分も分母に入るので、答えずに済ませることが多いモデルほど、低く出ます。Gemini 4のモデルは4〜20%、AAが載せているChatGPTとClaudeの行は34〜85%でした。数字だけでは、間違えにくいのか、答えずに済ませているのかを見分けるのは難しそうです。低い数字を、そのまま「間違えにくい」と受け取らないほうがよさそうです。
どんな時にどの設定?
設定はアプリの名前で書いています。根拠は、Googleの公式の説明と、APIの段で測った数字です。右端の数字はAPIの段のもので、アプリの設定との対応がはっきりしないため、表の設定は、公式の説明と数字から組み立てた目安として見てください。
| こんな時 | 設定 | 公式の説明 | APIの段の目安 |
|---|---|---|---|
| 短い質問、言葉の言い換え | 自動モード、 またはHydrogen・低 | 低は、単純な質問に速く簡潔に答える設定。Hydrogenは日常の作業向け | Hydrogen low: 最初の回答まで6.4秒、問題1つ$0.29 |
| メールや文章のたたき台、調べものの整理 | Hydrogen・標準 | 標準は、速さと深さのバランスをとる設定。Hydrogenは、そのまま使える文章づくりや調べものにも向くとGoogleが説明 | Hydrogen medium: 14.3秒、$0.80 |
| 資料や明細の突き合わせ、込み入った調べもの | Neon・標準〜高 | Neonは深さと効率のバランスをとった中間。Googleは、家計の明細の分析や領収書の突き合わせを例に挙げる | Neon medium:20.1秒、$1.90 Neon high:40.6秒、$3.74 |
| コードの修正、手順が長く続く作業 | Carbon・高 (鍵つき・Ultraのみ) | Carbonは最も強く、難しい長丁場の問題向け。高は、複雑で複数の段階がある質問を丁寧に考える設定 | Carbon high: 73.2秒、$7.76、出力速度55 |
| 時間をかけても質を優先したい | Neon・高、 足りなければCarbon・高 | Googleは、APIの助言で、Hydrogenで足りないときにNeon、速いモデルが行き詰まったときにCarbonを挙げる | Neon high: 計算上の時間14.8分 Carbon high: 計算上の時間37.1分 |
| 上限を長持ちさせたい | 低〜標準 | 高度なモデルと高い思考レベルほど使用量を多く使い、上限に達すると軽いモデルで続く | Neon low $0.75 → xhigh $6.44 |
| どれにするか決めたくない | 自動モード | 質問ごとにHydrogenか速くて軽いモデルと思考レベルを選び、使用量を節約する。NeonやCarbonが選ばれるとは書かれていない | ― |
出典:Artificial Analysis(Intelligence Index v5.0.1・APIで測定・2026年11月19日取得)。各モデルのページ:Gemini 4 Hydrogen、Gemini 4 Neon、Gemini 4 Carbon(※英語サイト・自動翻訳推奨)
ChatGPT・Claudeと並べる
並べる前の条件
並べる数字は、AAがAPIで同じ総合点(v5.0.1)を使って測ったものです。第三者の測定で、2026年11月19日の値です。段の名前はAPIのlow・medium・high・xhigh・maxです。ClaudeやChatGPTのアプリの段の名前とは別のものとして見てください。Claudeでは、考える深さの設定を「effort(エフォート)」と呼びます。Claudeの行は、安全装置の切り替えが有効な状態(AAの表記はDefault Fallback)で測った値です。Carbonの費用は、AAが12月1日からの単価で計算した値です。段の数はモデルによって違い、無い段は「―」にしています。
- Claude Fable 5.2:Anthropic(アンソロピック)が、いちばん難しい技術の仕事向けとするモデル
- Claude Opus 5.5:ふだんのコーディングや知識の仕事は、まずこれから、とAnthropicが勧めるモデル
- Claude Sonnet 5.5:Opusより単価が低いモデル
- GPT-6.2 Astra:アストラと読みます。OpenAIが、難しいプロジェクトを最初から最後まで支える高性能モデルと説明
- GPT-6.2 Sol:OpenAIが、日常業務で幅広く使える定番モデルと説明
設定ごとの総合点と費用
| モデル | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | 27点 $0.29 | 41点 $0.80 | 51点 $1.87 | 54点 $3.16 | ― |
| Gemini 4 Neon | 44点 $0.75 | 55点 $1.90 | 59.6点 $3.74 | 61点 $6.44 | ― |
| Gemini 4 Carbon | 54点 $7.19 | 58点 $6.59 | 60点 $7.76 | ― | ― |
| GPT-6.2 Astra | 46点 $0.66 | 57点 $1.62 | 60点 $2.07 | 61.6点 $2.52 | 62.1点 $4.00 |
| GPT-6.2 Sol | 41点 $0.18 | 53点 $0.41 | 55点 $0.56 | 56点 $0.65 | 57点 $1.01 |
| Claude Fable 5.2 | 54点 $3.10 | 56点 $3.80 | 61.8点 $9.08 | 62.2点 $14.83 | 65点 $26.54 |
| Claude Opus 5.5 | 35点 $0.98 | 48点 $2.45 | 52点 $3.46 | 57点 $6.05 | 59点 $10.04 |
| Claude Sonnet 5.5 | 26点 $0.51 | 31点 $0.78 | 42点 $1.64 | 50点 $4.09 | 55点 $10.02 |
出典:Artificial Analysis(Intelligence Index v5.0.1・APIで測定・2026年11月19日取得)。各モデルのページ:Gemini 4 Hydrogen、Gemini 4 Neon、Gemini 4 Carbon、GPT-6.2 Astra、GPT-6.2 Sol、Claude Fable 5.2、Claude Opus 5.5、Claude Sonnet 5.5(※英語サイト・自動翻訳推奨)
この表の中で、総合点がいちばん高いのはFable 5.2のmax、費用がいちばん低いのはSolのlowです。highの段で、質問を送ってから最初の回答が出るまでを比べると、いちばん早いのはSonnetの9.5秒、次がSolの11.1秒で、Neonは40.6秒、いちばん遅いのはCarbonの73.2秒です。
出典のURLと、総合点の9つのテスト
アプリ側の違い
Claudeのアプリでは、effortの段がLow・Medium・High・Extra high・Maxの5つあります。アプリの既定はMediumで、APIの既定とは別だとAnthropicは書いています。月額は、Proが年払いで$17(月払いは$20)、Maxが$100、Ultraが$200です(Anthropicの料金ページ、11月19日。※英語サイト・自動翻訳推奨)。Geminiアプリの思考レベルは3段で、既定は「低」です。
ChatGPTのAPIでは、推論にかける労力(effort)の値として、none・minimal・low・medium・high・xhigh・maxが挙げられています(OpenAIの推論の説明ページ、11月19日。モデルごとに使える値は違います。※英語サイト・自動翻訳推奨)。GPT-6.2のAstraとSolはnoneを受け付けず、OpenAIは最新モデルの案内で、新しく使い始めるときはmediumからと勧めています。「pro」はeffortの段ではなく、effortとは別に選ぶモードです。
ChatGPTのアプリの月額は、OpenAIの料金ページ(11月19日)に、Goが$8、Plusが$20、Proが$100からと出ています。Proは利用枠が3段階あり、段ごとの金額は書かれていません。日本円の表示は、ページにはありませんでした。
ChatGPTのアプリで選べる思考時間の段は、OpenAIの文書で確かめられた範囲では、AAのlow〜maxと対応づけられないので、上の総合点の表の列とは並べられません。OpenAIの文書には、Codexの「Extra high」とAPIの「xhigh」の両方が出てきますが、同じ段という説明は書かれていないようです。いまのChatGPTのアプリで段を選んでいる方がいたら、教えてください。
Claudeの新しいモデルFable 5.2の数字は、前の記事で見ています。
Claudeのモデルとエフォートの組み合わせは、こちらの記事に書きました。
題名にChatGPT・Claude・Geminiの3つが並んだ教科書もあります。楽天ブックスで2,420円でした(11月19日時点)。

世間の評判
Neonは11月18日に出たばかりなので、使い込んだ人の声はこれから増えていきそうです。いまは、発表の前後に出ていた声と、HydrogenやCarbonを使った人の感想から、いくつか拾いました。どれも書いた人の印象で、数字の裏づけまでは付いていない声です。
使い分けの助言
使い分けは、ふだんは自動かHydrogenにして、足りない仕事だけ上のモデルに切り替える、という助言が目立ちました。ミーネクスト(11月19日)は、まずHydrogenか自動で出してみて、答えが浅い・読み落としがあると感じた仕事だけNeonに切り替える順番を勧めています。AIworkerのnoteも、迷ったらまずHydrogenで試して、足りない仕事だけ上位モデルに回す、という書き方です。どちらもGoogleの公式の位置づけを下敷きにしているので、独立した意見が重なったというより、同じ出どころの言い換えという見方もできそうです。
noteに書かれた感想
Hydrogenを試したまさおさん(11月13日のnote)が「速くて手頃なのに頭もいい、手を動かす役のモデルです。」と書き、「画面やターミナルの操作は Claude、費用は GPT 系に分があります。」とも書いています。まさおさんはAPIやCursorで試した感想で、アプリでの使い心地とは別の話です。れん学長さん(11月15日のnote)は、highだけで試した感想として「なんかめっちゃ硬い感じがしますね」と書いています。
Xでの反応
X(旧Twitter)の声は、X上で使えるAIのGrokに、11月18日と19日の投稿を探してもらいました。投稿そのものは、ぼくは開いて見ていません。
Grokが挙げた8件のうち、呼び名や新しい選び方への反応は4件でした。1件は、メニューの文言を紹介して、NeonはHydrogenとCarbonの中間にあたり、階層がはっきりしたと受け止めた投稿です。1件は、元素の名前だけではGemini 4の中での位置が伝わらず、ブランドとして分かりにくいという声でした。1件は、Argonがもう使えなくなったことに触れ、急に元素記号の路線になったという感想です。残る1件は、新しいモデルは好きだけれど、Geminiの名前の付け方は少し分かりにくい、という声でした。
使ってみた体験談は、8件のうち2件で、どちらもNeonを好意的に書いていました。1件は、少し使っただけで良さが分かり、文章力も速度も精度も不満がないという投稿です。もう1件は、Neonが賢いおかげもあって、Geminiアプリが見違えるようだという投稿でした。
ChatGPTやClaudeとの使い分けに触れたのは、8件のうち2件です。1件は、Neonが出たことでClaudeが一人勝ちする時代が終わりそうだという見方で、ChatGPTはほとんど使っていないとも添えています。もう1件は、Neonだと気づかずに回していたDeep Researchが、精度も速度もまとまりも一段上がったと感じて満足で、Claudeだけに頼る度合いが下がってきた、という投稿です。
メニューの鍵のアイコンに触れた投稿は、Grokの検索では見つからず、低・標準・高の使い心地を書いた投稿も、Grokの答えではほぼ見つからなかったそうです。
まとめ
アプリのメニューは、役割の言葉と3つのモデルに、思考レベルは低・標準・高の3段になりました。速さ・値段・正確さは、モデルと段で大きく動きます。迷ったときは、自動モードか、Hydrogenの低〜標準から始めて、足りないときに上のモデルや高い設定へ進むのが、公式の説明に沿った選び方に見えます。
コメント