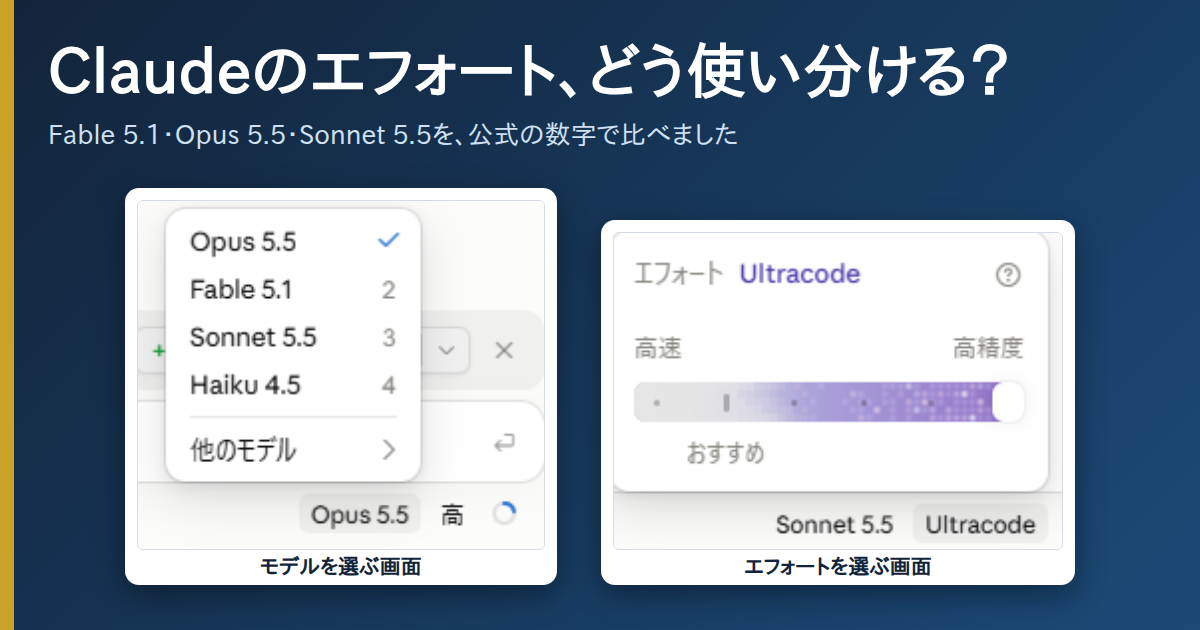
Claudeのエフォート(モデルがどれくらい念入りに考えるかの設定)は、結局どう使い分ければいいんでしょう。ぼくがいま使っているClaude Codeの画面を開くと、Opus 5.5のエフォートが「高」になっていました。
いちばん気になっているのは、Fable 5.1・Opus 5.5・Sonnet 5.5の3つを、エフォート「中・高・超高」で使ったらどう違うのか、というところです。そこで、Anthropicが公表しているベンチマーク(AIに同じ課題を解かせて点数を付ける共通のテスト)の数字をもとに、賢さ・安さ・速さを、1〜10の点数に直してみました! 3つは測った課題が違うので、足した総合点は作っていません。
後半では、ぼく自身がClaude Codeの中でモデルをどう使い分けているかも書きます。
この記事を書いたきっかけは、Anthropicが9月28日に出したSonnet 5.5の発表です(英語サイト・自動翻訳推奨)。

Claudeのエフォート使い分け、まず15通りを1枚の早見表で
この表の見かた
まずは全体像を見てもらいますね。下の表は、Fable 5.1・Opus 5.5・Sonnet 5.5の3モデルに、エフォートの5段階(低・中・高・超高・最大)を掛け合わせた15通りを並べたものです。公式のドキュメントでは、エフォートは low・medium・high・xhigh・max の5段階で書かれていて、ぼくの画面の「超高」は、並び順からすると公式の xhigh に当たるようです。
点数は、どれも10に近いほど望ましい(賢い・安い・速い)向きにそろえました。
- 賢さ(コーディングでの目安):プログラミング系の3つのテストの正答率の平均を、10で割って四捨五入した点数です。
- 安さ:テストの課題を1つ解かせたときの費用(米ドル)を点数にしました。10がいちばん安く、1目盛り違うと費用はおよそ2倍違います。
- 速さ:第三者の計測サイトArtificial Analysis(AA)が測った、1問あたりの時間(秒)を点数にしました。10がいちばん速く、1目盛り違うと時間はおよそ2倍違います。賢さ・安さとは測った課題が違います。くわしくは「速さを“秒”で見てみる」の章に書きました。
どのマスにも、元になった正答率(%)・費用(ドル)・時間(秒)を小さく添えています。点数の横の数字も見てもらえれば、ぼくが付けた点数を自分で検算できます。
早見表:3モデル×5段階
色の付いた行が、いちばん知りたい「中・高・超高」の9通りです。低と最大は白い行にしました。右端の速さの列は、賢さ・安さとは測った課題が違います。
表1の見かた(例:Sonnet 5.5の「超高」の賢さの欄)
6 平均55.57%
TB4 61.5% / FC 52.1% / CB 53.1%
- 青い四角は、10段階の点数を表す印です。賢さ・安さ・速さの3列とも、10に近いほど望ましい向きです。
- 四角の横と下の小さな数字は、点数の元になった数字です(賢さは正答率、安さは費用、速さは1問あたりの秒数)。
※TB4=Terminal-Bench 4.0、FC=FrontierCode 1.1、CB=CursorBench 4.0の正答率です(それぞれの中身は、ベンチマークの章で説明します)。正答率の「平均」は3つの単純平均、費用の「平均」は3つの費用を掛け合わせて3乗根を取った平均(幾何平均)です。「境目」は、点数を分ける線から±10%以内にあるマスで、元の数字が少しぶれると点が1つ動くかもしれません。賢さと安さの数字は2026年9月29日に公式サイトで確かめた値、速さの数字は同じ日にArtificial Analysisから取得した値です。新しいモデルが出ると変わります。Sonnet 5.5は公開から2日目で、速さの点が取得した時刻によって1つ動くことがあります(中は、117.9秒のときは8点、126.5秒のときは7点でした)。そのため、点数の横に秒数を添えています。
エフォートやモデルの選び方は、Claude Codeを使い込むほど気になってくる部分です。使い方の土台から知りたい方向けに、Claude Codeの入門書も出ています。

点数の付け方と、読むときの注意
10段階の点数は、Anthropicが公表した数字を、決まった式でぼくが1〜10に直したものです。式は次のとおりです。
- 賢さ=(TB4・FC・CBの正答率の平均)÷10 を四捨五入(最低1)。たとえば平均54.90%なら5です。
- 速さ=1問あたりの時間(秒)を、次の帯に当てはめます。10=30秒以下/9=〜60秒/8=〜2分/7=〜4分/6=〜8分/5=〜16分/4=〜32分/3=〜64分/2=〜128分/1=128分超。たとえば214.0秒なら7です。
- 安さ=3つの費用の幾何平均を、次の帯に当てはめます。10=$0.25以下/9=〜$0.5/8=〜$1/7=〜$2/6=〜$4/5=〜$8/4=〜$16/3=〜$32/2=〜$64/1=$64超。たとえば$1.896なら7です。
読むときの注意は6つあります。
- 精度:1点の差は、測り方のぶれの範囲に収まることがあります。この記事で「差がある」と書くのは、元の数字がはっきり離れているところだけです(賢さは正答率で4.16ポイント以上、速さは時間で1.25倍以上)。この線は、Terminal-Benchで公表されている誤差のうち、いちばん大きいOpus 5.5の±2.6ポイントを、ほかの2つのテストにも当てはめて出したもので、ぼくの仮定が入っています。速さの1.25倍も、ぼくの決めた目安です。
- 賢さの範囲:賢さは、プログラミングの課題3種類の正答率の平均で、文章を書く力や調べ物の上手さは対象外です。難しい課題を集めたテストなので、どのモデルも満点よりだいぶ低いところに並びます。
- 安さの意味:費用は、テストの課題1つを解かせたときの金額で、発表ページのグラフの値です。計算の前提はテストごとに違い、一部は公表されていません。ProやMaxの定額プランで使う枠の減り方とは別のものです。
- 速さの意味:速さは、第三者の計測サイトArtificial Analysisの「1問あたりの時間」を使いました。Claudeが考える文と答えを書き出し続ける時間の目安で、最初の文字が出るまでの待ちや、道具を動かす時間は入っていません。1問はArtificial Analysisが独自に作った10種類の評価の平均で、アプリで1回返事をもらうときの待ち時間とは種類が違います。1問あたりの時間は、Artificial Analysisが1問ごとに書き出したトークンの数を、この書き出しの速さで割り、評価の重みをつけて平均した値です。書き出しの速さのほうは、AnthropicのAPI(Claudeを呼び出す窓口)に直接、1件ずつ、約1万トークンの入力で測ったもので、直近72時間の中央値です。どちらも2026年9月29日に取得しました。毎日変わりますし、使うたびにも変わります。1目盛り違うと、時間はおよそ2倍違います。
- 3つの数字の違い:賢さ・安さ・速さは、それぞれ別のテストの数字です。3つを足した総合点は作っていません。
- 版:使ったのは Terminal-Bench 4.0、FrontierCode 1.1、CursorBench 4.0 の値だけです。名前が同じでも版が違う値とは比べられません。
表の上つきの※は、次のことを表しています。
- ※1(Fable 5.1・Opus 5.5):この2つは、危険な依頼を止める仕組み(安全装置)を入れたまま測られていて、公式もそのぶん点数が下がっている可能性が高いと書いています(Fable 5.1の発表ページ・Opus 5.5の発表ページ。どちらも英語サイト・自動翻訳推奨)。
- ※2(Fable 5.1):Anthropicは、Fable 5.1と、同じモデルで安全装置の作りが違うMythos 5.1との差について、安全装置を改良したので差はずっと小さくなる見込みだと書いています。
- ※3(Sonnet 5.5の最大):FrontierCodeでは、最大のほうが超高より点が低く、費用も高くなっています。公式の脚注(Sonnet 5.5の発表ページ・英語サイト・自動翻訳推奨)によると、最大ではコードの見直し用の機能(確認をたくさんの小さな作業役に分けるもの)を使うことが増え、調べた2件では時間切れか、頼まれた範囲の外まで直してしまい、点が下がりました。
- ※4(Fable 5.1の低):FrontierCodeの52.8%は、発表ページに載っている値です。ただ、Anthropicのシステムカード(モデルの詳しい技術資料)どうしで、この点の読み取りが少し食い違って見えるところがあり、ぼくには決めきれませんでした。49.8%だったとしても点数は5のままなので、表の点はそのまま使えます。
ここまでで、表の読み方は一通りです。次の章では、エフォートとモデルそれぞれの基本を、短くおさらいします。
エフォートとモデルを30秒でおさらい
エフォートは、モデルが考える深さの設定
エフォートは、Claudeが答えを出す前に、どれくらい考えるかを決める設定です。高くするほど念入りに考えますが、そのぶん時間もトークン(AIが文章を処理するときの文字のかたまりの単位)も増えます。日本語のヘルプでは「努力レベル」と呼ばれています。
段階は、公式のドキュメント(Claude Codeのモデル設定ページ・英語サイト・自動翻訳推奨)だと low・medium・high・xhigh・max の5つです。ぼくの画面には「低・中・高・超高・最大」、それにUltracodeが並んでいます。日本語のヘルプには、xhighが「非常に高い」と書かれていました。
同じ「高」でも、モデルが違えば中身は同じではありません。公式のドキュメントも、エフォートの目盛りはモデルごとに調整されていると説明しています。
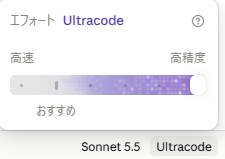
上の画面写真は、Sonnet 5.5を選んだときのエフォートの画面です。左端が「高速」、右端が「高精度」で、左寄りに「おすすめ」の文字があります。
エフォートそのものの説明は、以前の記事にも書きました。以前の記事では、発表ページに出てきた呼び名として low・high・xhigh・max の4つを挙げましたが、いまの公式ドキュメントには low・medium・high・xhigh・max の5つが載っています。
モデルは3つ。画面の並びと単価
モデルは、この記事ではFable 5.1・Opus 5.5・Sonnet 5.5の3つです。ぼくの画面のモデル選択メニューでは、上からOpus 5.5(選択中)・Fable 5.1・Sonnet 5.5・Haiku 4.5と並んでいて、いちばん下に「他のモデル」があります。
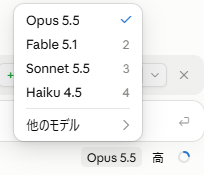
Sonnet 5.5を選ぶと、「Sonnet 5.5はより高速で、範囲が明確なタスクを得意とします。」という案内も出ました。

お金の面では、料金は100万トークンあたりの米ドルで決まっています。公式の料金ページ(英語サイト・自動翻訳推奨)の数字を、そのまま並べます。出力の単価は、Fable 5.1がOpus 5.5の2.5倍、Sonnet 5.5の5倍です。
※MTokは「100万トークン」の略で、金額はすべて米ドルです。キャッシュ読み込みは、一度読ませた指示や資料を、次のやり取りでもう一度読み直すときの、割安な処理の値段です。2026年9月29日に公式ページで確かめた数字です。
Fable 5.1とOpus 5.5のどちらを選ぶかは、以前の記事にまとめています。
Ultracodeは、段階ではなく別のスイッチ
Ultracodeは、エフォートの段階ではなく、Claude Codeの別の設定です。公式のドキュメント(英語サイト・自動翻訳推奨)によると、オンにすると、中身のあるタスクごとに、ワークフローを組んでくれます。ワークフローの説明ページ(英語サイト・自動翻訳推奨)によると、ワークフローは、たくさんのサブエージェント(仕事を分担するAIの作業役)を同時に動かすスクリプトで、定額プランではそのトークンが使用量の枠から引かれるので、セッションごとや週ごとの枠に早く届きます。版によって扱いも違い、v2.1.284より前は、オンにするとxhighになり、ほかの段階を選ぶとオフになる作りでした。段階として数字にできないので、この記事の表には入れていません。
エフォートとかトークンとか、AIの中身がどうなっているのかが気になった方には、図解で基本と仕組みを説明した入門書もあります。

1段上げると値段は何倍になるか
エフォートを上げると、モデルは長く考えるので、出力するトークンが増えて費用も増えます。では、どれくらい増えるのか。表1の「安さ」の元になった、3つのテストの1課題あたり費用(の幾何平均)を、「高」を1として並べ直したのが下の表です。
「高」を1としたときの費用の倍率
この表の見かた:棒と右の数字は、「高」を1とした費用の倍率です。棒が長いほど費用が大きく、10段階の点数とは向きが逆です。
※数字は、発表ページのグラフに載っている3つのテスト(TB4・FC・CB)の1課題あたり費用の幾何平均を、そのモデルの「高」の値で割ったものです。バーの下の小さな$は、割る前の費用です。棒の長さは倍率どおりで、いちばん長いSonnet 5.5の最大を赤にしました。2026年9月29日に公式サイトで確かめた値です。
Sonnet 5.5は、超高から最大で急に高くなる
Sonnet 5.5は、高から超高で2.89倍、超高から最大で、さらに4倍あまり($3.198が$13.608)に増えます。それなのに、賢さの点数は超高も最大も6で、元の正答率は55.57%と57.43%。差は1.87ポイントなので、この記事の基準では同等です。ぼくの見立てでは、最大は「ここぞ」のときだけの選択肢です(表の※3の事情もあります)。
Opus 5.5とFable 5.1は、最大でもそこまで急には伸びません(Opus 5.5は3.82倍、Fable 5.1は2.05倍)。Opus 5.5の中は、高の0.74倍の費用です。賢さは、中(54.90%)と高(58.07%)で同等です(差3.17ポイント)。
定額プランで使う人の考え方
ここまでの費用は、API(アプリやサービスからClaudeを呼び出す窓口で、使った分だけ払います)の定価で計算した金額で、ProやMaxなど定額プランの使用量の減り方とは別のものです。定額プランのほうは、日本語のヘルプ(モデル、努力レベル、思考設定を変更する)に、こう書かれています。「努力が高いほど、より徹底的な応答が得られますが、時間がかかり、より多くのトークンを使用するため、使用制限に達するのが早くなります。」
Fable 5.1については、Claudeの料金ページ(日本語版)に、こう書かれています。「Claude Fableモデルは、Max planに週間使用量の上限の50%まで含まれています。Proユーザーは使用クレジットでFableにアクセスできます。」定額プランで使っている人は、どのモデルを選ぶかで、枠の減り方も、プランの枠に含まれるかどうかも変わる、ということです。
使用クレジットの話は、Claude Codeで最大250ドルのクレジットが配られたときの記事にもまとめています。
Claude Codeに最大250ドルのクレジット配布、押すとどうなる?
この定額プランの枠の中で、Claude・Gemini・ChatGPT・Grokの4つを順番に回して1つのアプリを作るとしたら、どう配るのか。実際に回した記録ではなく、各社の公式の情報から組み立てたシミュレーションを、別の記事にしています。
速さを“秒”で見てみる
エフォートを上げると、考える量が増えるぶん、答えを書き終えるまでの時間も延びます。では、どれくらい延びるのか。公式が出している時間の数字と、第三者の計測サイトの数字を見てみます。
公式の速さの4つの語
Anthropicのモデル比較のページ(英語サイト・自動翻訳推奨)には、モデルごとの「速さ」の欄があって、4つの語が使われています。
- Fable 5.1:Slower(より遅い)
- Opus 5.5:Moderate(中くらい)
- Sonnet 5.5:Fast(速い)
- Haiku 4.5:Fastest(いちばん速い)
それぞれの語が何秒くらいなのかの説明は、調べてみたのですが見つけられませんでした。この4つの語は、表1の速さの点には使っていません。数字で分かるのは、前の版との比較です。Sonnet 5.5はSonnet 5より、Opus 5.5はOpus 5より、出力がどちらも30%以上速いと、Anthropicは発表しています。Opus 5.5の発表ページ(英語サイト・自動翻訳推奨)には、アクセスを複数のサーバーに振り分けるソフト「HAProxy」をC言語からRustに書き換える社内テストで、Fable 5.1が12時間、Opus 5.5が9.5時間だったという例もあります(エフォートは書かれていません)。
エフォート別の時間が、公式に出ている例
エフォートごとの時間を数字で出しているのは、調べた範囲では、Sonnet 5.5のシステムカード(英語サイト・自動翻訳推奨)と、Fable 5.1が出てくる公式の最適化ページ(英語サイト・自動翻訳推奨)でした。どちらも、コーディングの速さではなく、医療の質問や長い調べものでの例です。Opus 5.5の分は、この2つには載っていません。
まず、Sonnet 5.5のシステムカードにある、医療系のテストの例です。
- 一般的な健康の質問(HealthBench):低から超高までは1回答8〜13秒、最大だと約36秒
- 医療の専門家からの質問(HealthBench Professional):低から超高までは12〜26秒、最大だと約160秒
- 電子カルテを操作する医療の作業(PhysicianBench):高で1課題あたり2分未満、超高で約4分、最大で約14.5分
時間だけでなく、正答率の動きも書かれていました。一般的な健康の質問は、5つの段階すべてで点数(回答の長さを補正した値)が0.7ポイントの範囲に収まっています(64.7%〜65.4%)。電子カルテの作業のほうは、低と中の点数(27.2%と30.0%)は区別できず、そこから上は、段を上げるほど点数が上がっていきました。上げるほど賢くなるかどうかは、仕事の種類で変わる、ということです。
次に、Fable 5.1です。公式の最適化ページには、14個のプログラムのパッケージ(合わせて2,160万トークン分のコード)に仕込まれた130個の欠陥を探す課題で、1回あたりの時間が、低は15.2時間、中は17.5時間、高は19.9時間だったと書かれています。費用は3段とも468〜552ドルの範囲に収まっています。
同じページには、Fable 5.1の「中」と「高」を比べた数字もあります。中にすると、高に比べて時間が、物理の研究レベルの問題(Anthropicの社内テスト)で9%、専門家が作った幅広い分野の難問集HLEで39%、調べものの深さを見るDRACOで30%短くなり、費用は順に37%、43%、25%安くなりました。物理だけは、費用が37%減ったのに時間は9%しか減らず、その差もぶれの範囲に入っています。
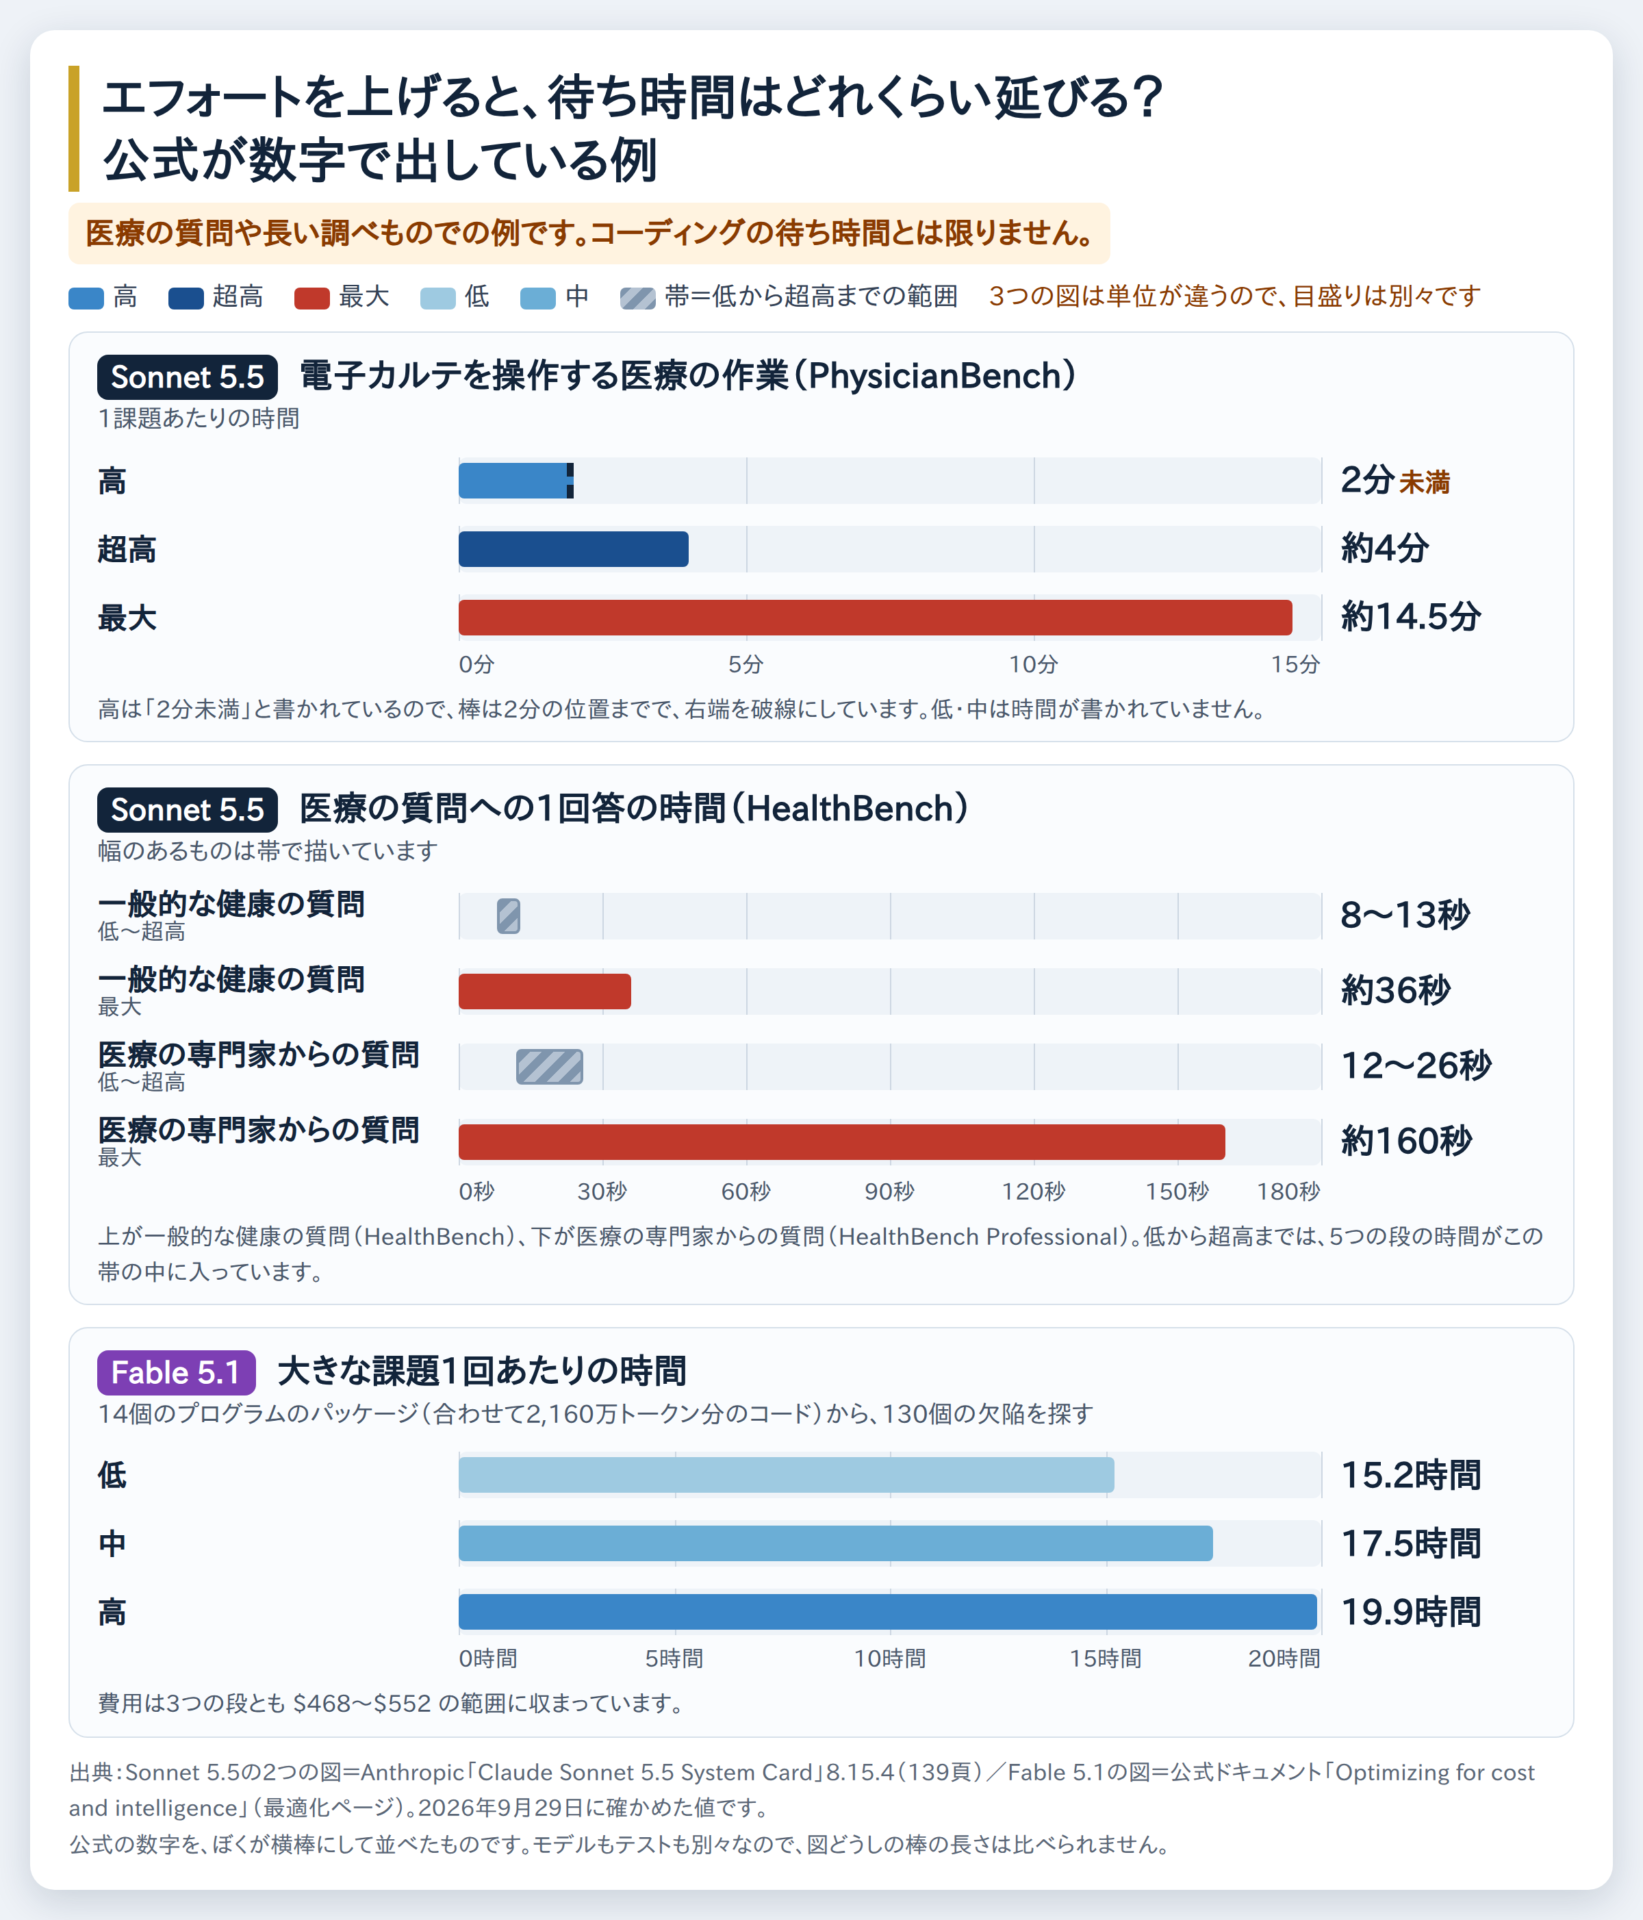
※図Bは、公式の数字をぼくが横棒にして並べたものです。医療の質問や長い調べものでの例なので、コーディングの待ち時間とは限りません。
第三者の計測で、3モデルを並べて見る
3つのモデルを同じ条件でそろえて測っているのが、第三者の計測サイトArtificial Analysis(AA。英語サイト・自動翻訳推奨)です。AAは、独自に作った10種類の評価(知識・推論・コーディングなどの混合)をモデルとエフォートごとに解かせ、1問あたりにかかった時間を公開しています。表1の速さの点と秒数は、この「1問あたりの時間」です。賢さ・安さとは測った課題が違います。
同じモデルの中では、段を上げると時間が延びます。Sonnet 5.5は、低から中で1.33倍、中から高で1.71倍、高から超高で1.95倍、超高から最大で2.04倍です。Opus 5.5は、低から中で2.49倍、高から超高で1.75倍、超高から最大で1.58倍。Fable 5.1は、低から中が1.29倍、中から高が1.35倍、高から超高が1.48倍で、超高と最大はほぼ同じ(1.10倍)です。
同じ段でモデルを並べると、こうなります。
- 低:Sonnet 5.5(95.5秒)とOpus 5.5(86.1秒)はほぼ同じで、Fable 5.1(256.9秒)は2.7〜3倍かかります。
- 中:Sonnet 5.5(126.5秒)、Opus 5.5(214.0秒)、Fable 5.1(331.5秒)の順に速く、どの組も1.5倍以上の差があります。
- 高:Sonnet 5.5(215.8秒)、Opus 5.5(290.0秒)、Fable 5.1(446.9秒)の順に速いです。Opus 5.5とFable 5.1の差は1.54倍で、点数はどちらも6ですが、差があります。
- 超高:Fable 5.1(662.7秒)は、Opus 5.5(506.1秒)の1.31倍、Sonnet 5.5(420.7秒)の1.58倍かかります。Sonnet 5.5とOpus 5.5は、ほぼ同じか、少し差がある程度です。
- 最大:3つとも約730〜860秒(Sonnet 5.5が858.7秒、Opus 5.5が800.4秒、Fable 5.1が729.2秒)で、ほぼ同じか、少し差がある程度です。
最初の1文字が出るまでの待ち
もうひとつ、待ち時間で気になるのが、返事の最初の1文字が出るまでの時間です。Sonnet 5.5の公式の手引き(英語サイト・自動翻訳推奨)には、エフォートがmedium(中)以上だと、挨拶にも短く考えてから返すので、最初の文字が出るまでの時間が増える、と説明されています。low(低)だと、簡単な依頼ではほとんど考えないそうです。
待ち時間そのものを縮めたい方には、Opus 5.5には、出力が最大2.5倍速くなる代わりに単価が上がる高速モード(Claude Codeでは /fast)もあります(速くなるのは出力の速さで、最初の文字までの待ちは縮まらないそうです)。気になる方は、公式の説明ページ(英語サイト・自動翻訳推奨)を見てみてください。
Sonnet 5.5の中は、8点にも7点にもなります
AAの数字は毎日変わります。Sonnet 5.5は公開から2日目で、同じ9月29日のうちに、中の1問あたりの時間が117.9秒(8点)から126.5秒(7点)に動きました。この記事の表は、そのあとに取り直した2026年9月29日の値(126.5秒、7点)で、秒数を添えています。1つ隣の点との差は、測り方のぶれの範囲に収まることがあるので、点数より秒数を見てもらえればうれしいです。
ここまでで、値段と速さの話は一区切りです。次の章では、賢さのほうを、ベンチマークで見ていきます。
回答のすごさ:ベンチマークで比べる(コーディングでの目安)
ここからは、賢さの点数の元になったベンチマークを見ていきます。ベンチマークは、AIに同じ課題を解かせて、正答率などで点数を付けるテストのことです。この記事で使ったのは、プログラミング系の3つだけです。文章を書く力や調べものの上手さは測っていないので、「コーディングでの目安」として見てください。
使った3つのテスト
- Terminal-Bench 4.0(TB4):ターミナル(コマンドを打ち込む画面)の上で、複雑で手順の多い仕事をやり遂げられた割合です。
- FrontierCode 1.1(FC):AIが書いたコードの変更が、人の手直しなしで取り込まれる(マージされる)かを見るテストです。頼まれた範囲の外まで直すと減点されます。
- CursorBench 4.0(CB):プログラミング用のエディタ「Cursor」での実際の作業から取った、あいまいで、複数のファイルにまたがる課題です。
どれも100点満点の正答率です。3つとも、Anthropicの発表ページにある、エフォート別のグラフの点だけを使っています。
値段と賢さの地図
15通りを、費用(横)と3つのテストの平均正答率(縦)の地図にしてみました。左上にあるほど、安くて賢い組み合わせです。3つのモデルそれぞれ、低から最大までの5つの点を線でつないでいます。
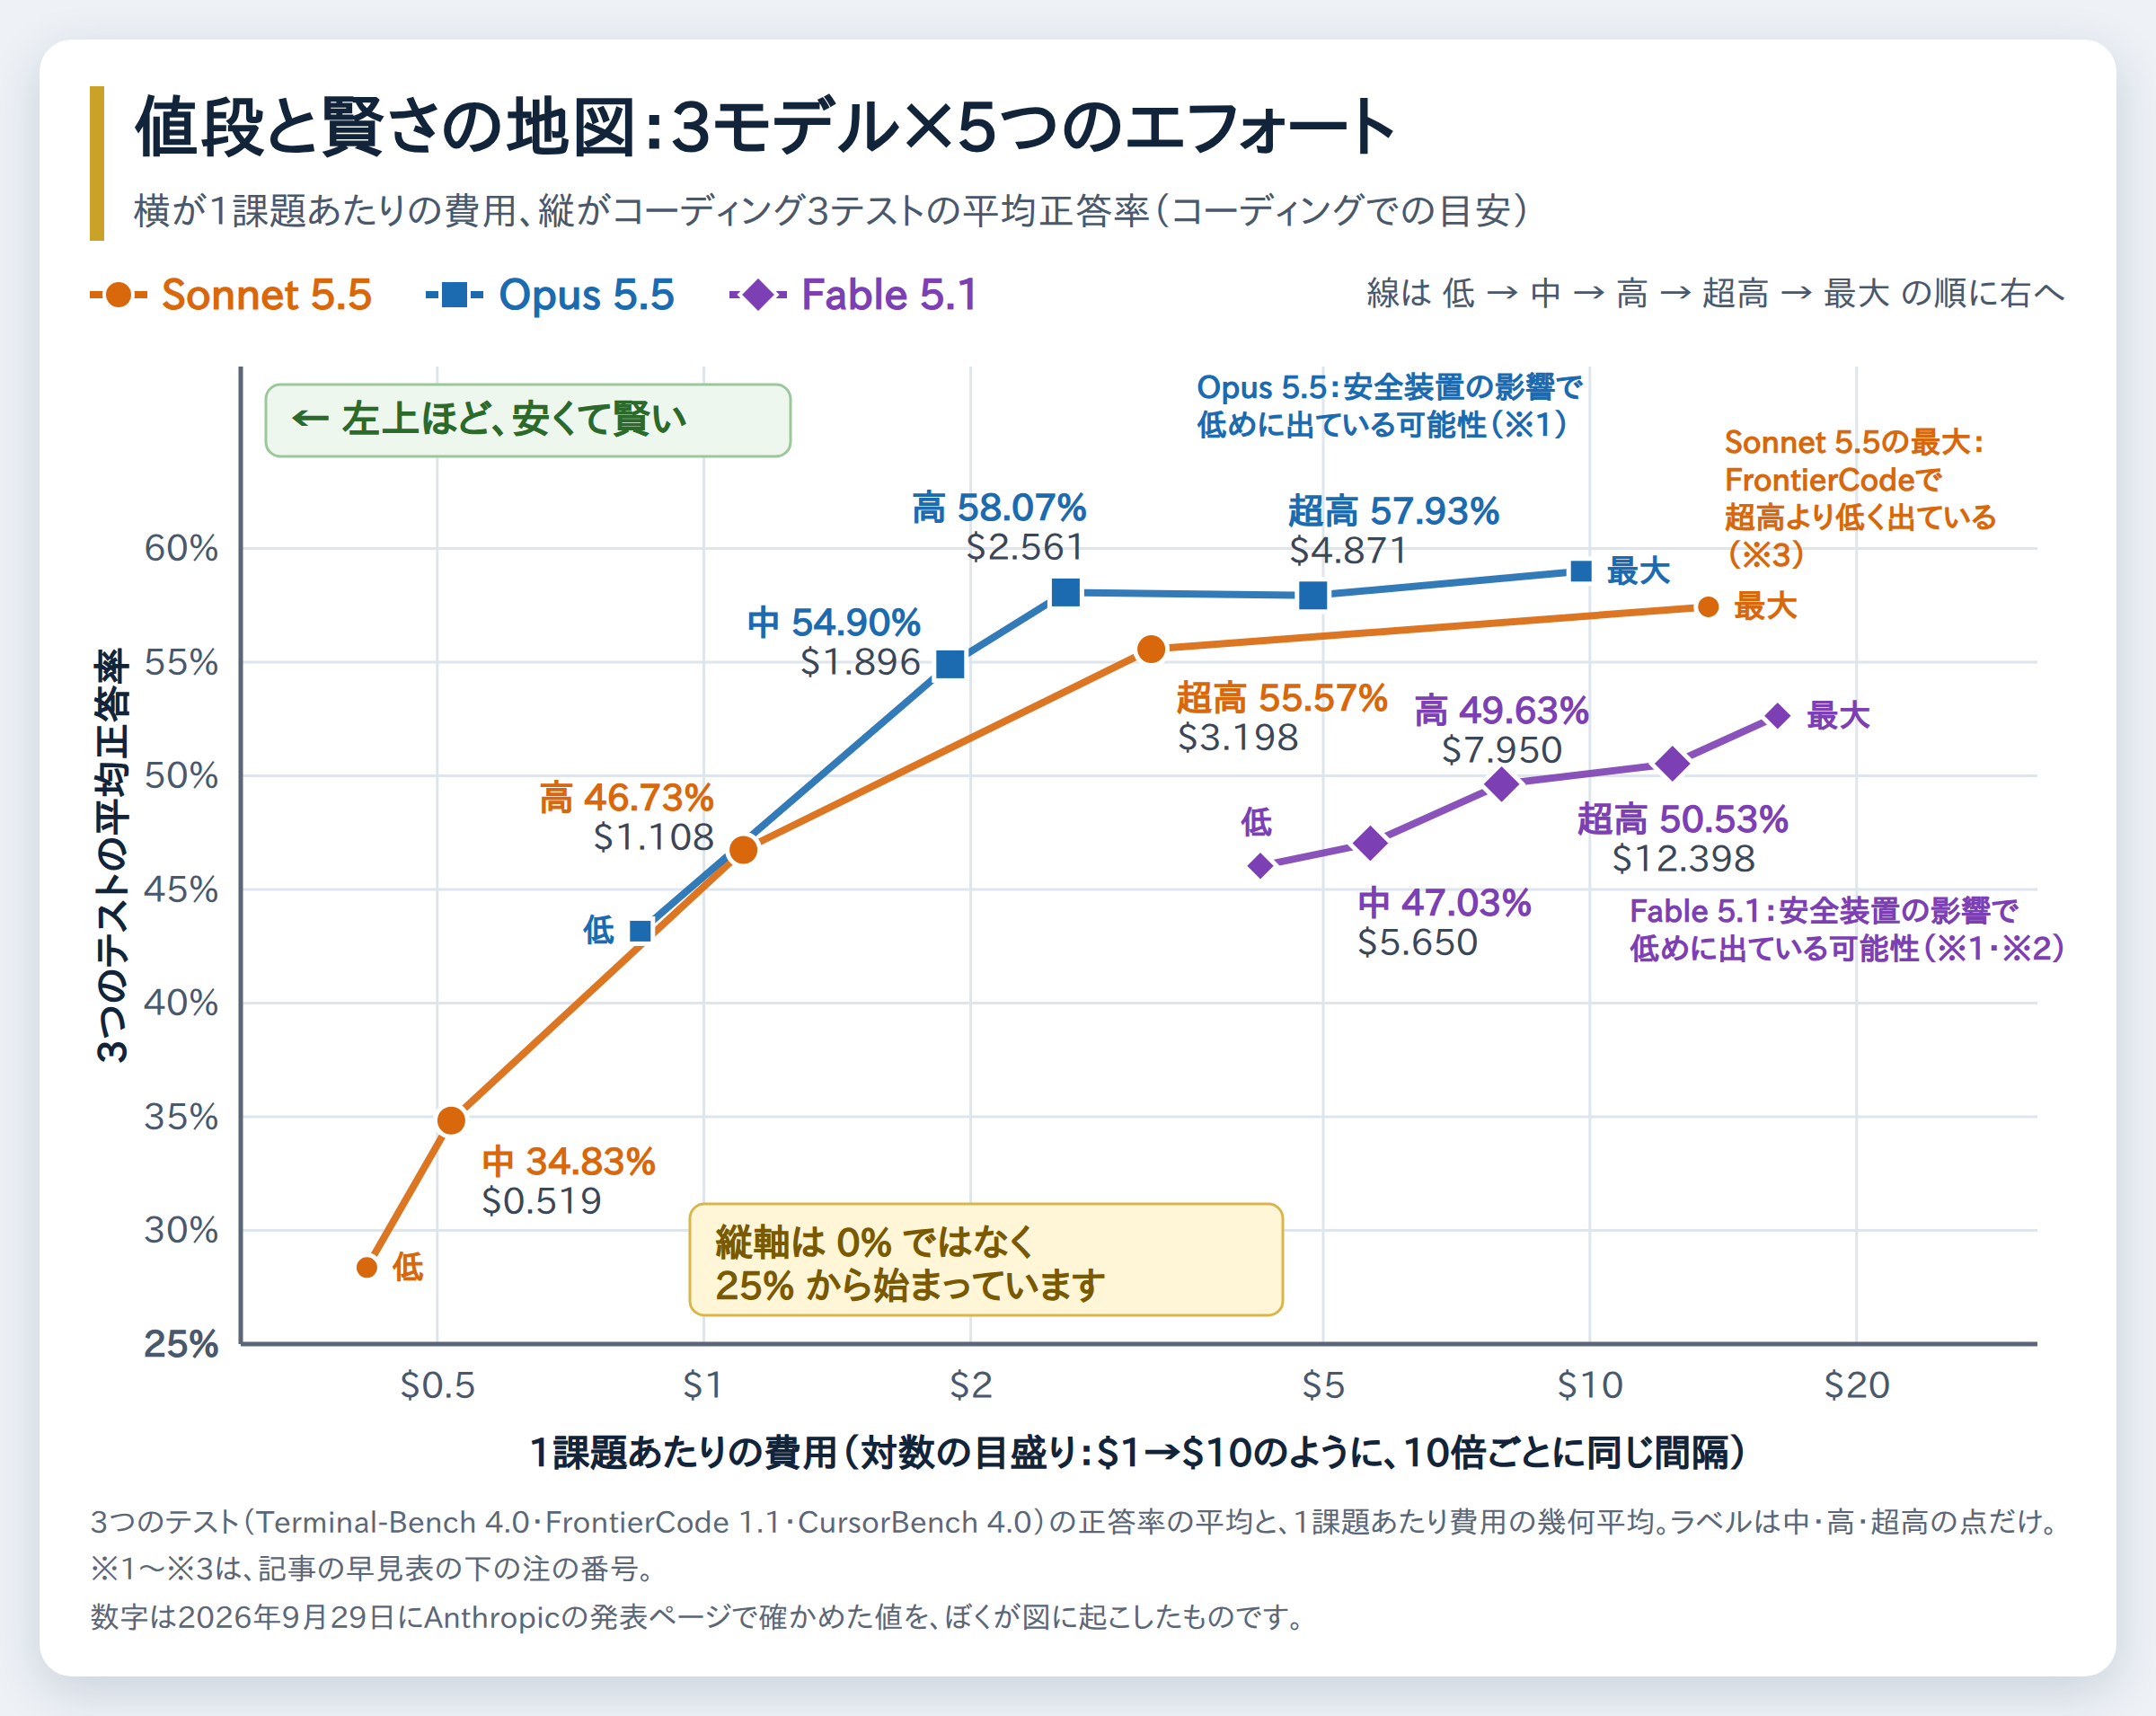
地図を見て気づいたことを、元の数字で書いておきます。「差がある」と書くのは、元の正答率で4.16ポイント以上離れているところだけです。
- Opus 5.5:低から中で、正答率が43.17%から54.90%へ大きく上がります(差あり)。中から先は、高58.07%、超高57.93%、最大59.00%と横ばいで、隣り合う段どうしはどれも同等です。
- Sonnet 5.5:低28.37%、中34.83%、高46.73%、超高55.57%と、超高までは隣り合う段どうしすべてに差があります。最大の57.43%は、超高と同等です。
- Fable 5.1:低46.03%から最大52.63%まで、隣り合う段どうしは、どれも同等です(差は0.90〜2.60ポイント)。
同じ段でモデルを並べると、こうなります。
- 低:Sonnet 5.5(28.37%)は、Opus 5.5(43.17%)とFable 5.1(46.03%)のどちらよりも低く、差があります。Opus 5.5とFable 5.1は同等です(差2.87ポイント)。
- 中:Sonnet 5.5(34.83%)がいちばん低く、Opus 5.5(54.90%)はFable 5.1(47.03%)より上で、どちらも差があります。
- 高:Opus 5.5(58.07%)が上で、Sonnet 5.5(46.73%)との間にも、Fable 5.1(49.63%)との間にも差があります。Sonnet 5.5とFable 5.1は数字の上では同等ですが、どちらが上とは言いにくいところで、理由は次の見出しに書きます。
- 超高:Opus 5.5(57.93%)は、Fable 5.1(50.53%)より上で、Sonnet 5.5(55.57%)とは同等です。Sonnet 5.5とFable 5.1の比べ方は、次の見出しで説明します。
- 最大:Opus 5.5(59.00%)は、Fable 5.1(52.63%)より上で、Sonnet 5.5(57.43%)とは同等です。Sonnet 5.5とFable 5.1の比べ方は、ここも次の見出しで説明します。
Fable 5.1の点が低めに出る理由
ここまでの数字は、そのまま「Fable 5.1は賢くない」とは読めません。理由は2つあります。
- Fable 5.1とOpus 5.5は、危険な依頼を止める仕組み(安全装置)を入れたまま測られています。公式も、そのぶん点数が下がっている可能性が高いと書いています。
- Terminal-Bench 4.0の最大では、Fable 5.1が55.8%、同じモデルで安全装置の作りが違うMythos 5.1が60.9%でした。Anthropicは、この差は以前の精度の低い安全装置が介入した課題のぶんで、改良した安全装置では差がずっと小さくなる見込みだと書いています。
なお、Fable 5は同じ3つのテストの点がそろわないので表に入れておらず、Mythos 5.1は限られた人向けのモデルなので、この説明のためだけに名前を出しました。
そのため、高・超高・最大でSonnet 5.5とFable 5.1のどちらが上かは、安全装置の影響で入れ替わるかもしれないので、どちらが上とは言いにくいところです。超高と最大は、いまの数字だとSonnet 5.5のほうが上(超高で5.03ポイント、最大で4.80ポイント)ですが、安全装置の影響を除くと差は縮む可能性があります。Opus 5.5とFable 5.1の差は、Fable 5.1のTerminal-Bench 4.0を、安全装置の違うMythos 5.1の値に置き換えて試算しても残りました(差は4.60〜5.87ポイントで、4.16の線に近い大きさです。Opus 5.5側の影響は数字がないので、置き換えていません)。
Fable 5.1は、Anthropicが手強い推論や長時間のエージェント作業(AIが自分で手順を組んで進める仕事)向けと案内しているモデルです。今回の3つのテストが測れているのは、その得意分野の一部です。
上げれば上がる、とは限らない
エフォートを上げれば、いつも点が上がるわけではありません。
- Opus 5.5のFrontierCodeは、中54.6%、高54.0%、超高51.4%で、上げるほど数字が少しずつ下がっています。ただ、1つのテストだけで見ると、この程度の差は測り方のぶれの範囲に収まることがあるので、「下がる」ではなく「上がっていない」と読むのが安全です。
- Sonnet 5.5の最大は、FrontierCodeが超高52.1%から最大46.2%へ下がり、費用は$1.59から$20.78に増えています。理由は、表の※3に書いた公式の脚注のとおりです。
1点の差を、読みすぎない
点数の差と、この記事の判定がずれる組もあります。
- Opus 5.5の中(5)と高(6):点は1つ違いますが、同等です(差3.17ポイント)。
- Opus 5.5の低(4)とFable 5.1の低(5):こちらも同等です(差2.87ポイント)。
- Sonnet 5.5の低と中:どちらも3ですが、差があります(差6.47ポイント)。
- Opus 5.5の中とFable 5.1の中:どちらも5ですが、差があります(差7.87ポイント)。
だから、表の点数は「1点違うから違う」と読まず、その横の元の%と、この判定を見てもらえればうれしいです。
エフォートやモデルの割り当てを考えるうちに、「仕事をAIにどう分担させるか」に興味が出てくる方もいるかもしれません。複数のAIエージェントを組み合わせる設計の本もあります。

ぼくの使い分け:作業役はSonnet、確認役はOpus、Fableはここぞのときだけ
役割ごとにモデルを分けています
ぼくはClaude Codeの中で、仕事の担当を分けて動かしています。手を動かす作業役(実行者)にはSonnet、その出来を確かめる確認役(部長)にはOpusを割り当てています。Fableは単価が高いので、いつもの設定には入れず、ここぞというときだけ手動でオンにします。Haikuは、任せられる単純な仕事が今のところ無いので、使っていません。
なぜこの分け方なのか
Sonnetは、手順が決まった作業なら品質がほとんど落ちず、そのうえ安いからです。Opusには、確認と判断の質を守ってほしいので、確認役を任せています。厳密にモデルを比べたわけではなく、これまでの使い心地から決めた分け方です。
使い分けのきっかけは、会話が通じなかったこと
この使い分けを始めたきっかけは、8月ごろの出来事でした。ぼくとやり取りする秘書役に、そのときのSonnet 5を使ったら、こちらの質問の意図が伝わらず、話が空回りしたんです。Opus 5に替えたら一度で通じたので、「Opus5だったら会話が通った気がする」と思いました。
Claude Codeでこういう役割分担を作っていった過程は、以前の記事にもまとめています。
Claude Code 会社を作る|行き詰まりと作り直しの実録
読者の使い方に置き換えると
ぼくの分け方を、ふつうの使い方に置き換えると、次の3つに分けて考えるのが分かりやすいと思います。手順が決まった作業は、安いモデルに任せます。出来を判断するところは、判断の質を守れるモデルに任せます。ここぞという難所だけ、いちばん上のモデルを手動で使います。この記事の表は、どの段階でどれくらい費用が増えるかを見て、それぞれに当てるモデルとエフォートを決めるための材料になります。
迷ったらこれ:アプリの人/Claude Codeの人
ここまでの数字を、アプリで使う人と、Claude Codeで使う人に分けて、それぞれ3行にまとめます。どちらも、ぼくの見立てです。
アプリで使う人は
アプリのほうは、ベンチマークの点数は持ち込まず、公式の説明だけで決めます。
- 迷ったら、メニューで「デフォルト」と付いているエフォートのまま使います。日本語のヘルプによると、各モデルに推奨のエフォートがあり、メニューに「デフォルト」と表示されます(Sonnet 5.5とFable 5.1のアプリでの初期値は中です)。
- 簡単な質問や普通の文章づくりは、低か中が向いています。Sonnet 5.5は中以上だと挨拶にも短く考えるので、短いやり取りが多いなら、低にするのも手です。
- 難しい相談で物足りないときだけ、高に上げます。高は品質と速度のバランスがよい段階とされていますが、上げるほど時間がかかり、使用制限にも早く届きます。
Claude Codeで使う人は
- 迷ったら、Opus 5.5の「中」です。Claude Codeの初期設定で、賢さ5・安さ7。高との元の正答率の差は3.17ポイントで同等なのに、費用は高の0.74倍です。速さは7点(1問あたり214.0秒)で、高(290.0秒、6点)より1.35倍速いです。
- 手順の決まった作業を安く回したいなら、Sonnet 5.5の「高」(賢さ5・安さ7)です。点数はOpus 5.5の中と同じ5・7ですが、元の数字は違います。Opus 5.5の中(54.90%・$1.896)と比べて、Sonnet 5.5の高(46.73%・$1.108)は、費用がおよそ6割になる代わりに、正答率が約8ポイント(8.17ポイント)下がり、この記事の基準では差があります。秒数はOpus 5.5の中とほぼ同じ(215.8秒と214.0秒)です。Sonnet 5.5の中だと賢さが3に下がって差が出ます。超高(賢さ6・安さ6)に上げると、費用は高の2.89倍になります。最大は、超高と同等のまま、費用だけが4倍あまりに増えます。
- Opus 5.5で物足りない難所だけ、Fable 5.1を手動で使います。公式も、Opus 5.5でエフォートを上げても足りないときにFable 5.1を使う流れを案内しています。Fable 5.1の高は446.9秒(速さ6)で、Opus 5.5の高(290.0秒、速さ6)より1.54倍かかります。Claude CodeでのFable 5.1の初期設定は高です。定額プランだと、Fable 5.1はMaxなら週の枠の50%まで、Proなら使用クレジットです。
参考:Haiku 4.5・Opus 5・Sonnet 5
1つ前の世代のOpus 5・Sonnet 5と、Haiku 4.5も、参考として並べます。Opus 5・Sonnet 5は、旧世代の初期設定にあたる「高」で比べています。
この表の見かた
下の表の5のような青い四角は、表1と同じ10段階の点数で、10に近いほど望ましい向きです。エフォート「高」のときの点で、四角の横と下の小さな数字は、元の正答率・費用です。
※5(Sonnet 5の高):Terminal-Bench 4.0が4.5%と極端に低く、平均の取り方を変えると点数が2つ以上動くので、参考として見てください。数字は2026年9月29日に公式サイトで確かめた値です。
Haiku 4.5は、公式のモデル比較で速さがFastestとされている小さなモデルです。賢さと安さは、同じ物差しの点がないので「―」にしました。速さは、AAが思考ありの設定で測っていて、1問あたり179.3秒(7点)でした。思考なしの設定は1問あたりの時間がなく、500トークンを書き出し終えるまで6.7秒と載っています(点数には使っていません)。同じテストで並べられる数少ない項目が、大学院レベルの理科の問題を集めたGPQA Diamondで、Haiku 4.5は63%、Opus 5.5は92%でした(Opus 5.5を測ったエフォートは書かれていません)。公式の最適化ページ(英語サイト・自動翻訳推奨)は、Haiku 4.5を、量が多くて答えを確かめやすい仕事に向くモデルとして紹介しています。
Haiku 4.5は、公式の一覧(英語サイト・自動翻訳推奨)によると、早くても2026年10月15日以降に提供が終わる予定です。Haiku 5.5は、Sonnet 5.5の発表ページで、数週間以内に加わる予定と案内されています。出たら、この表も変わります。スマホでモデルを選ぶ画面は、以前の記事で紹介しています。
Claude スマホ 使い方!この記事はOpus 5が書きました
迷ったときの流れ図
ここまでの「迷ったらこれ」を、1枚の流れ図にしました。
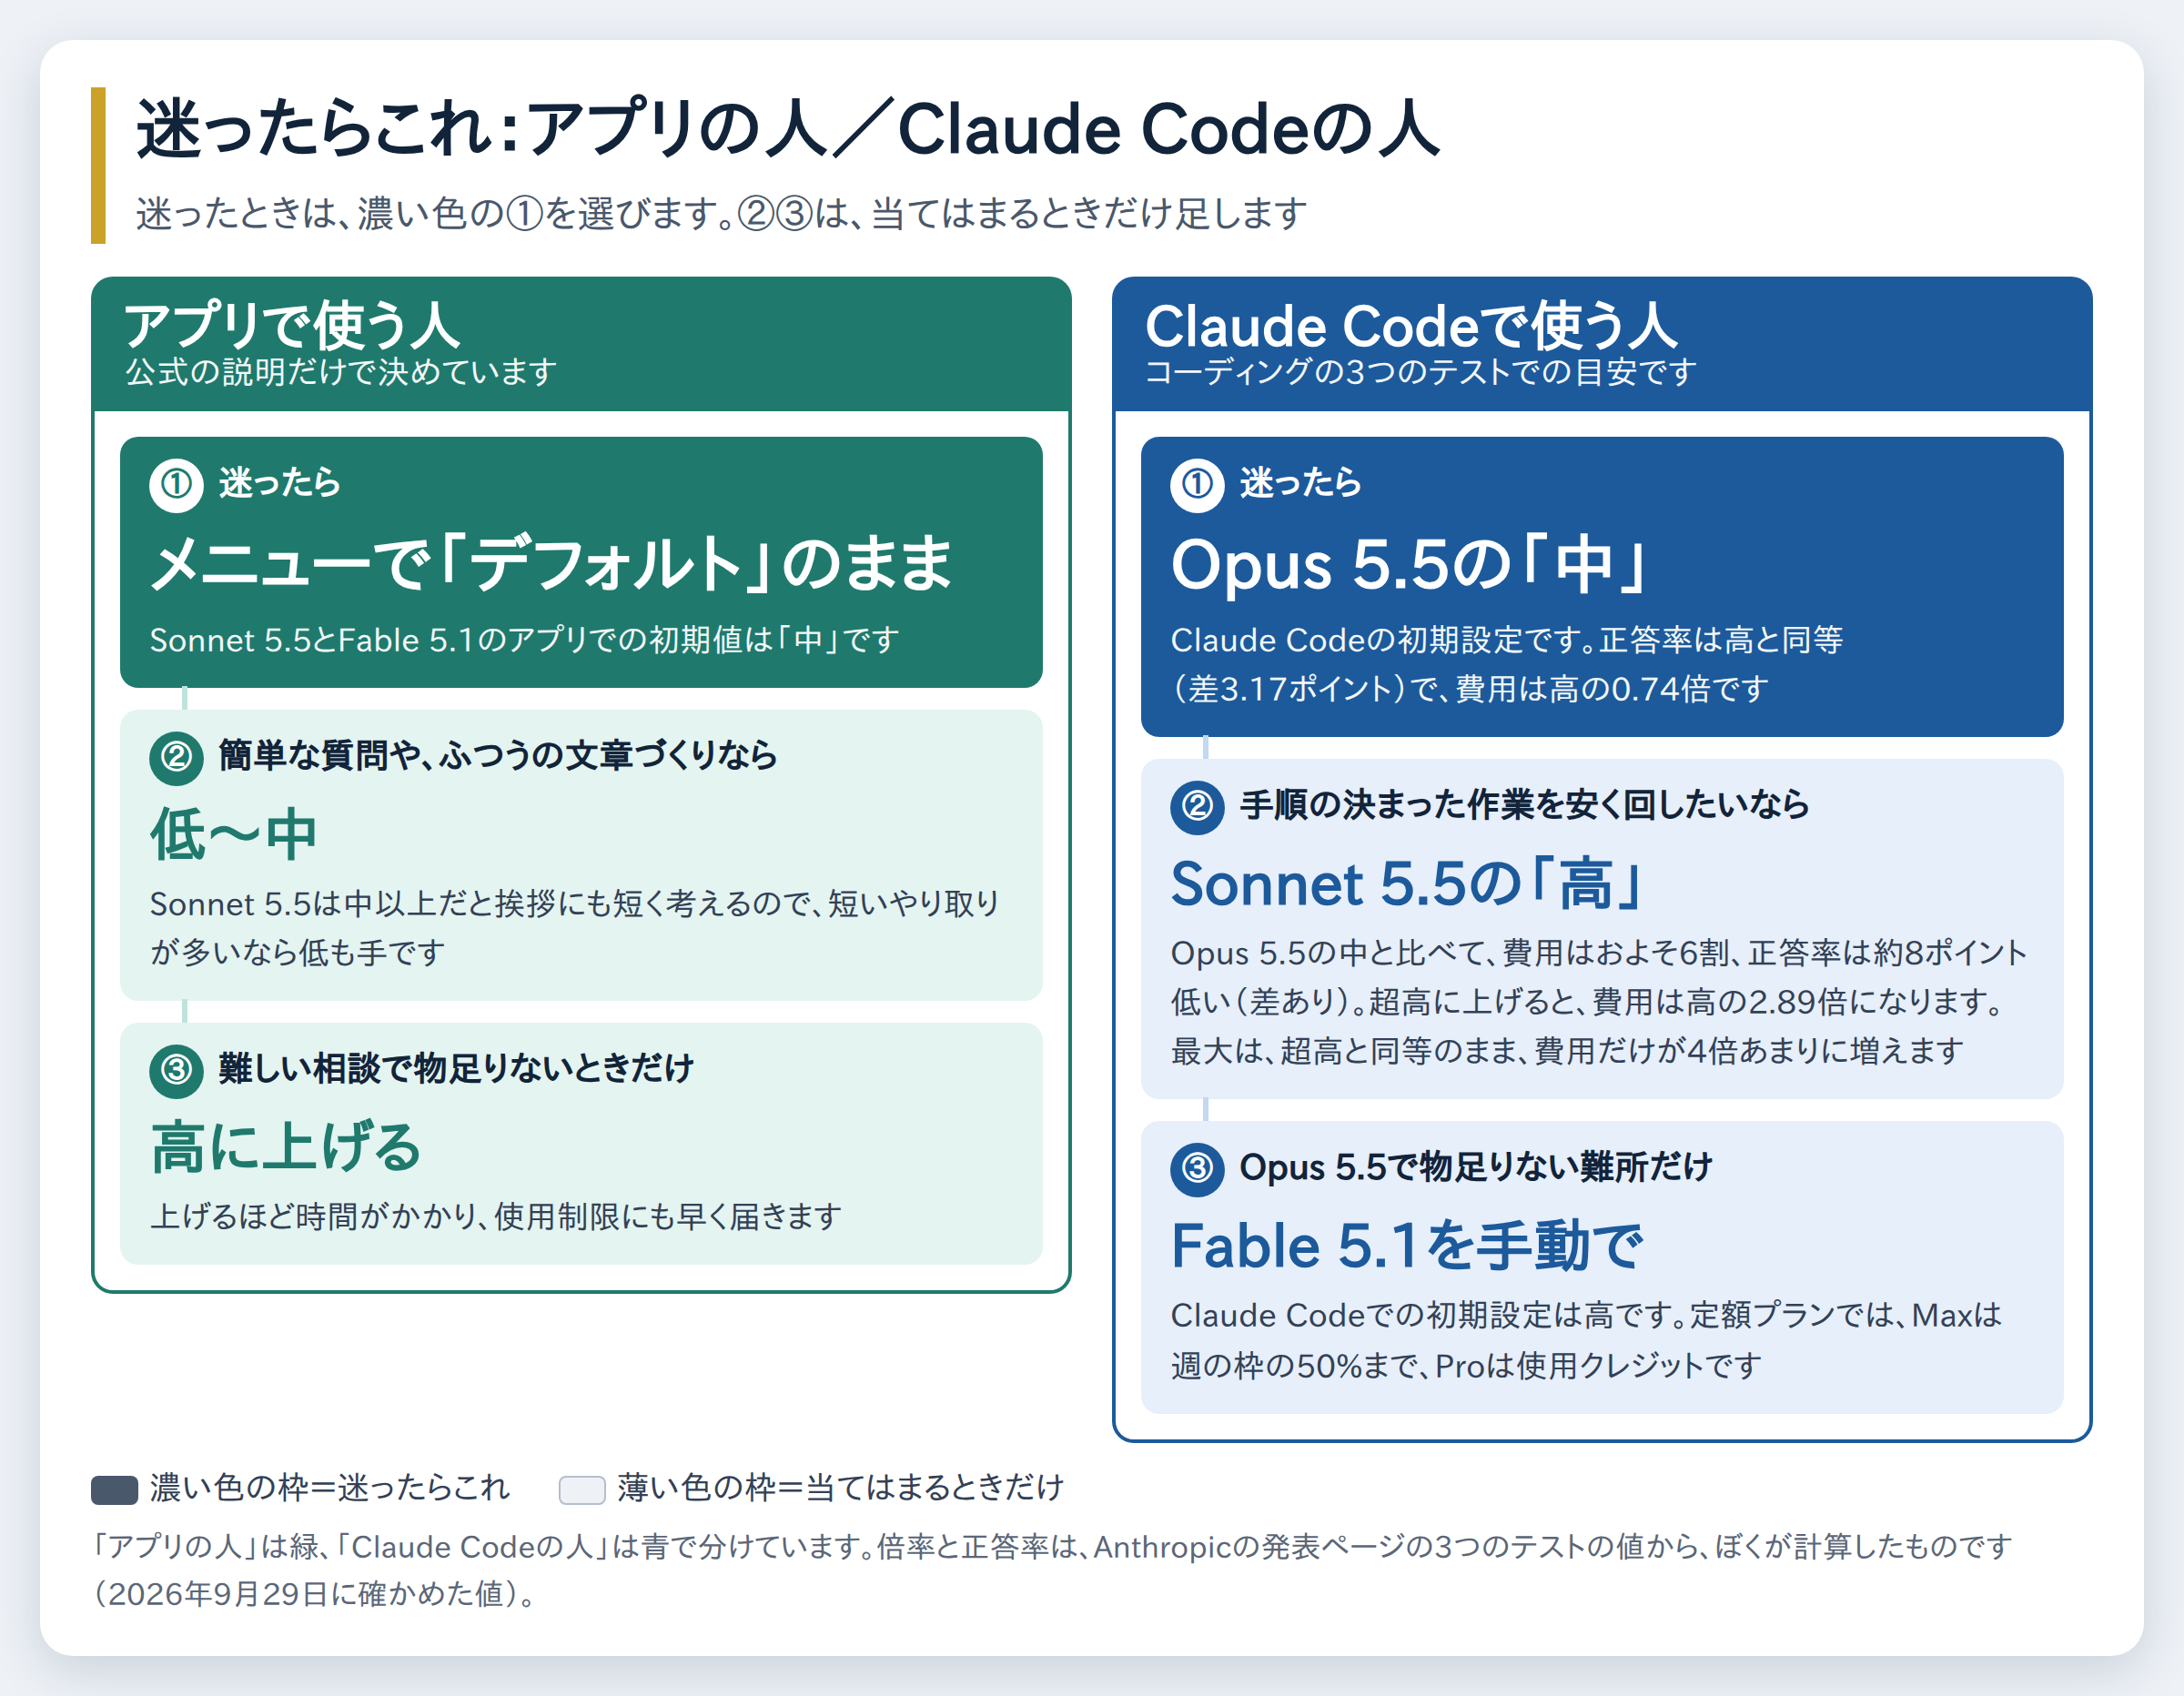
アプリでClaudeを使い始めたばかりの方向けの入門書も、あわせて置いておきます。

「設定を触るのが不安」という方は、まず「デフォルト」のままで使ってみて、物足りなさを感じたところだけ上げていく形でも十分です。上げたときの費用の増え方は、この記事の表が目安になります。
まとめ:エフォートの使い分けは、仕事の重さで決める
この記事で見えたこと
- エフォートを上げれば賢くなる、とは限りません。Opus 5.5は中と高で、Sonnet 5.5は超高と最大で、それぞれ同等でした。
- 費用は、段を上げるほど増えます。Sonnet 5.5の最大は、高の12.28倍まで増えました。
- Fable 5.1の点は、安全装置の影響で低めに出ている可能性があるので、順位づけには向かない数字です。
- 速さは、第三者の計測でも、段を上げるほど1問あたりの時間が延びました。Sonnet 5.5は、高の215.8秒から最大の858.7秒まで、約4倍です。
次にやってみたいこと
この記事は、公式の数字を並べ直してまとめたものです。3つのモデルをエフォートごとに使い比べた感触は、これから使いながら確かめて、別の記事にします。「作業役はSonnet、確認役はOpus」の分け方についても、続きを書けそうです!
コメント