日本時間の10月1日(米国時間は9月30日)、GoogleがAIの新しいモデル「Gemini 4 Argon」(アルゴン)を発表しました。発表と一緒にGemini 4 vs GPT-6 vs Claudeの比較表も出ていて、Argonが勝っている行がずらりと並んでいます。ぼくは普段Claude(Claude Code)を使っているので、Argonがどのくらいすごいのか、Claude CodeやChatGPTと比べてどこが上なのかが気になりました。
ただ、Argonは10月2日の時点で、一般の人にはまだ公開されていません。この記事では、Googleの表(19行)の強い所と負けている所、別の会社の評価、Claude CodeやChatGPTを使っている人がいま何をすればいいのかを見ていきます。
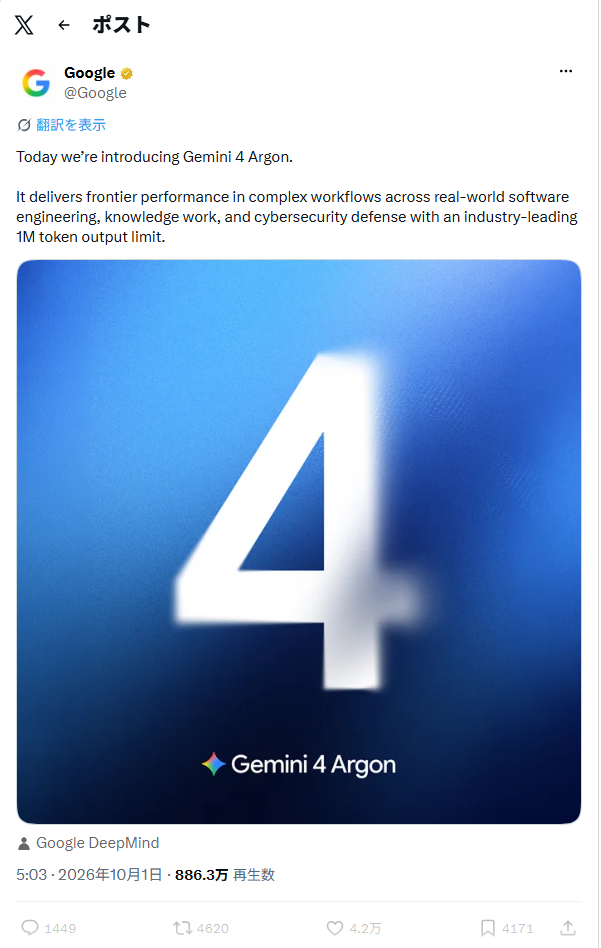
Googleの投稿は、実際のソフトウェア開発・知識労働・サイバー防御の複雑な作業で最先端の性能を出し、出力の上限は業界トップの100万トークンだとうたっています(ぼくの訳です)。
Claude Codeの基本を見直したい人向けに、8月14日発売の入門書が出ています。ぼくはまだ読んでいないのですが、Claude Codeを使う人に向けた1冊として置いておきます。

Gemini 4 vs GPT-6 vs Claude、Googleが出した19行の表
Googleの表は、Gemini 4 Argon・GPT-6 Astra・Claude Fable 5.1・Claude Opus 5.5を、19のテスト(ベンチマーク。AIの腕前を同じ問題で測る試験です)で並べたものです。数字はそのまま写し、各行の最高点を太字と黄色にしました。
出典:Googleの公式ブログと評価のPDF(どちらも英語。2026年10月2日に見たもの)。数字はどれも%で、元の表にある「Score」「Pass rate」「Offline subset/Partial score」などの注記は省きました。「—」は数字が載っていない所で、GraphWalksの括弧はトークン(AIが文章を数える単位)の数です。
数えると、Argonが最高の行は13、同点が1、負けが5です。ただし、評価のPDFに書かれた測り方を読むと、4つの条件はそろっていません。
- Argonは、Gemini API(開発者向けの窓口です)の最高の思考設定で、1回で解く条件です。ほかの3つは、多くの行で各社が出した数字や公開ランキングの数字です(PostTrainBench・LABBench 2・GraphWalks・LVBenchは、4つのモデルともGoogleが測っています)。
- DeepSWE v1.1・Terminal-bench 4.0・Terminal-Bench Science 0.1・Agent’s Last Exam・OSWorld-2.0は、Argonだけ、Googleが自分で測っています。Terminal-Bench Science 0.1は検証の制限時間が6倍、OSWorld-2.0は3回のうちの最良の値です。
- LVBenchは、動画から取り出す画像の数がモデルごとに違います(Argonは1秒に1枚、Astraは800枚、Fable 5.1は300枚、Opus 5.5は600枚)。Chartographyは、ツール(検索や計算など、AIが呼び出せる外部の機能)なしの条件です。
- CWE-bench v1の同点は、ArgonもAstraも68.0という意味で、順位表では4回試した成績で決める決まりです。
「13勝」は、Googleが選んだテストと条件での13勝、と受け止めるのがちょうどいいとぼくは思います。
差が大きいのは、どの行?
- 長い文脈:GraphWalksの25.6万〜100万トークンで84.2、2位のAstra(71.8)と12.4点の差です。12.8万トークンまでは99.7と98.7で、ほぼ並びます。
- 仕事の知識:Harvey’s Legal Agent Benchmarkは19.6で2位の約3倍ですが、最高でも20点に届かない難しいテストです。Vals Finance Agent v2とAutomationBenchは、2位に6〜9点の差です。
- 動画と理科:LVBench・LABBench 2・RiemannBenchで、2位より3.4〜4.2点上です。
表の外では、出力の上限(一度に出せる文章の長さ)が6.4万から100万トークンに増えたそうです。Opus 5.5とFable 5.1の最大出力は12.8万トークンなので、約8倍です。
冒頭に書いたとおりArgonはまだ一般には使えないので、いまのGeminiで先に慣れておきたい人には、5月12日発売の『Gemini AI活用 最強の教科書』が出ています。ぼくはまだ読んでいないのですが、Geminiを使う人に向けた1冊として置いておきます。

Argonの料金は、導入価格で入力100万トークンあたり$2、出力$10です。Opus 5.5は$4と$20、Fable 5.1は$10と$50なので、導入価格のうちはClaudeの2つよりArgonのほうが安い計算ですが、導入期間が終わると$4と$20になり、Opus 5.5と同じです。期間の長さは、Googleのブログに書いてないようです。
Claude Codeに近いテストでは、どうなっている?
Claude Codeと比べるなら、見ておきたいのはエージェント型のコーディング(AIがファイルを読み書きしながらプログラムを作る仕事)の4行です。Argonが最高なのはDeepSWE v1.1(77.9)とVibe Code Bench(91.9)の2行で、Googleのブログが、ソフトウェア開発で新しい最高水準になったと言う根拠も、このDeepSWE v1.1です。FrontierSWE v2(55.0)とTerminal-bench 4.0(57.4)は、4つのなかで最下位でした。
Terminal-bench 4.0は、ターミナル(文字を打ち込んで操作する黒い画面です)で何段階もある仕事をやり切れるかを測るテストだと、Anthropicの発表(※英語サイト・自動翻訳推奨)にあります。Claude Codeもターミナルで動くので、表の中ではこの行がClaude Codeの仕事にいちばん近いと思います。その行で、Opus 5.5(66.4)がArgonを9点上回っています。
ほかに負けているPostTrainBench・OSWorld-2.0(画面を見ながらパソコンを操作するテスト)・Terminal-Bench Science 0.1のうち、後ろの2つはAstraが最高で、Terminal-Bench Science 0.1のArgonは、制限時間6倍の条件でも3位でした。
同じ名前のテストでも、測り方が違うと数字は動きます。Terminal-Bench Science 0.1のOpus 5.5は、Googleの表で63.3、Anthropicの発表では58.7です。Chartographyは、Googleのツールなしの条件で66.3、Anthropicの発表(ツールあり)では89.0です。物差しが違えば順位も変わる、というのがぼくの受け止めです。
Anthropicも発表で、Opus 5.5とFable 5.1の差は点数が示すほど大きくなく、ベンチマークの差は現実の差の目安として当てにしにくくなったと書いています。Googleの表にも当てはまる話だと思います。2つの違いは、前に書いた記事にまとめました。

別の会社の物差しでは、どう並ぶ?
Googleの表は、Googleが選んだテストと条件でまとめたものです。そこで、AIの性能と費用を独立した立場で測っているとうたうArtificial Analysis(AA)の数字も見ました。総合の指数(10種類のテストを合わせた点数)を、10月2日にAAのサイト(※英語サイト・自動翻訳推奨)で見た値で並べます。
出典:Artificial Analysis(2026年10月2日に見たもの)。費用は、指数に入っている問題1つあたりの費用(米ドル)です。「max with fallback」は最大の設定で、安全のための仕組みが働いた問題は前のモデルが代わりに解く条件だそうです。
Opus 5.5が58でいちばん上、Argon・Astra・Fable 5.1が53で並びます。数字は整数なので完全な同点かは分からず、設定の書き方もモデルごとに違います。それでも、Googleの表で13行に勝ったArgonが、総合ではOpus 5.5に届かず横並びなのは見ておきたいところです。費用はArgonが$1.99でいちばん安く、Opus 5.5の約3分の1です。導入価格が終わるとArgonの料金はOpus 5.5と同じになるので、この差がどこまで残るのかは、ぼくにはよく分からなくて気になっています。
Gemini 4 Argonは、いつから使えるの?
Googleのブログによると、Argonは「Fairwind Program」を通して、信頼されたサイバー防御の担当者に先に出されています(サイバー面の安全装置を付けない版だそうです)。
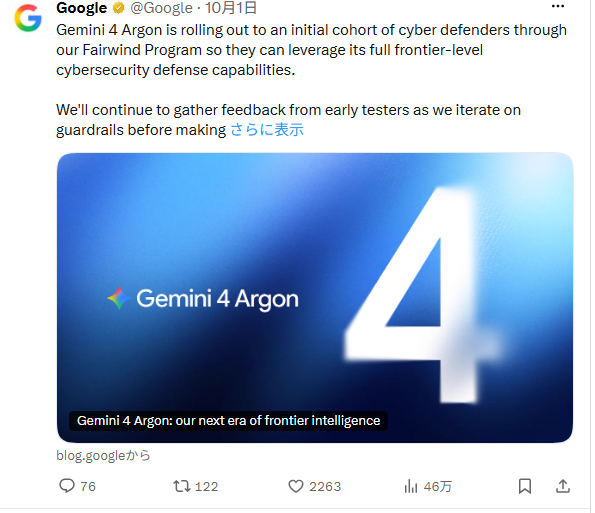
一般の人や会社に出すのはそのあとで、ブログには、有料のAPIの利用者とGoogle AI Ultraの加入者から、と書かれていて日付はありません。ぼくが入っているGoogle AI Proは、名前が出てきません。Geminiのアプリや開発ツールでいつ使えるようになるのかは、いまのところ分からないんです。
Claude CodeやChatGPTを使っている人は、いま何をすればいい?
ぼくはClaudeのProプランでClaude Codeを使っています。Proでは、Fable 5.1は枠に入らず、使った分だけ払う使用クレジットで使う形です(Claudeのヘルプ)。
- Claude Codeを使っている人:いまのモデルと設定のままで大丈夫そうです。Argonはまだ使えず、ターミナルの仕事に近いTerminal-bench 4.0では、Googleの表でもOpus 5.5が上でした。エフォート(AIが考える量の設定)の選び方は、Claudeのモデルとエフォートの比較にまとめました。
- ChatGPTを使っている人:Astraが最高だったのは、FrontierSWE v2・Terminal-Bench Science 0.1・OSWorld-2.0の3行です。パソコンの操作や理科系の仕事が多い人が、Argonに急いで乗り換える理由は、表からは見えません。とても長い文章や動画を読ませる使い方が多い人は、Googleの表で差が大きかった所なので、Argonが使えるようになったら比べてみる値打ちはありそうです。AstraがChatGPTのどのプランで使えるのかは、ぼくにはまだよく分からないので、気になる人はOpenAIの公式ページで見てみてください。
- Argonを試したい人:先に使えるのは、有料のAPIの利用者とGoogle AI Ultraの加入者です。導入価格の期間が分からないので、API料金の見積もりは$4と$20で考えておくと安心です。日付が出るまでは、Googleの公式ブログを見ておけば足ります。
ClaudeとGeminiの使い分けは前に書いた使い分けの記事に、ChatGPT・Gemini・Grokも入れた比べ方はClaudeを紹介した記事に書いています。
Claude・Gemini・ChatGPT・Grokを使える量の中で順番に回し、お互いの答えを見直させる、という使い方もあります。ミニ四駆のセッティング記録帳を作る想定でその手順と依頼文を書いた記事があります(実際に回した記録ではなく、各社の公式の情報から組み立てたシミュレーションです)。
ChatGPT・Claude・Geminiを1冊で見比べたい人には、12月4日発売予定(10月2日時点の販売ページの表記)の本が予約できます。まだ発売前なので、中身はぼくも読めていません。題名のとおり、3つのAIを1冊で扱う本だそうです。

まとめ
- Googleの表では、19行のうちArgonが最高13行・同点1行・負け5行です。強いのは長い文脈・仕事の知識・動画の理解で、出力の上限は100万トークン、導入価格も安い設定です。
- 負けているのは、Claude Codeに近いTerminal-bench 4.0やFrontierSWE v2など5行です。表は4つが同じ条件ではなく、AAの総合の指数ではOpus 5.5が58、Argon・Astra・Fable 5.1が53です。
- 10月2日の時点で、Argonは一般には出ていません。Claude CodeやChatGPTを使っている人は、いまの設定のまま、Googleの公式ブログに提供の知らせが出るのを待てば足ります。
コメント