Claudeのアプリに、こんな告知が出ていました。「新着」のバッジの下に、見出しは「Fable 5.2で最も困難な課題に取り組みましょう」。ClaudeのAIモデル「Fable」(フェイブル)の新しい版、5.2が来ました。
告知画面の背景は、左がオーロラの写真、右が夕焼けの空に青い球体の地平でした(タップで拡大できます)
Fable 5.2はどんなモデルで、どのくらいすごいのか。試す前に、公式の発表と、第三者が測った数字で確かめておくことにしました。ぼくはまだ使っていないので、これはその前の下調べです。それでも、期待はかなり大きいです。5.1から何が変わったのか、ChatGPTのGPT-6 AstraやGoogleのGeminiと並べるとどうなのかも、気になっています。
Fable 5.2 vs Astraの顔ぶれ
フェイブル?ファブル?
ぼくはFableをフェイブルと呼んでいます。検索すると「フェイブル ファブル どっち」という候補も出てくるので、読み方に迷う人がいるようです。
作っているのは、Claudeの開発元のAnthropic(アンソロピック)です。Claudeには何種類かのモデルが並んでいて、Fable 5.2は、いちばん難しい技術の仕事に向けたモデルだとAnthropicは説明しています。ふだんのコーディングや知識の仕事は、まずOpus 5.5から始めるのがおすすめ、とも書いています(Anthropicの発表ページ。※英語サイト・自動翻訳推奨)。

Fableと同じ中身で、安全装置(サイバー攻撃にかかわる危ない作業や、生物の研究の作業の大半を止めるしくみ)の程度が違うモデルにMythos(ミュトス)があります。Mythosは審査のある専用の窓口を通して提供されていて、一般に出ているのは、安全装置をしっかりつけたFableのほうです。発売は2026年11月9日で、Claudeの有料プラン(Pro・Max・Ultra・Team・Enterprise)で選べます。無料プランでは使えません。バージョンは、6月9日に5、9月1日に5.1、そして今回の5.2と、数か月おきに上がっています。
ChatGPTとGeminiの最新
比べる相手は、ChatGPTを作っているOpenAIの「GPT-6 Astra」(アストラ。2026年9月に公開)です。Googleは「Gemini 4」という世代で、10月13日に一般提供が始まった「Gemini 4 Argon」(アルゴン)と、10月28日に発表された「Gemini 4 Carbon」(カーボン)があります。
Carbonは、Googleが自社でいちばん強いモデルと呼んでいます。ただ、今は一部のサイバー防御者(セキュリティを守る側の専門家)向けの限定公開(使える人を限っての公開)です。開発者や一般の人に出すのはできるだけ早く、とGoogleは書いていて(Googleの発表ページ。※英語サイト・自動翻訳推奨)、誰でも使えるモデルにはまだなっていません。
名前が3社ぶん一度に並ぶと、頭が混ざりそうです。ChatGPT・Gemini・Claudeの使い方を1冊で扱っているムック(雑誌のような作りの本)が、今年の8月に出ていました。電子書籍で、楽天KoboでもKindleでも1,210円です(11月9日時点)。8月26日の発売なので、Fable 5.2やAstraの話は載っていませんが、3つのAIの違いを知る入口にはなるかもしれません。

Claudeの新着画面の3つの言葉
告知画面には、プランの話が1文と、Fable 5.2でできることを書いた3つの文が並んでいました。
Fable 5.2は、週間使用量の50%を上限としてプランに含まれています。
アニメーション、シミュレーション、3Dワールドで複雑なアイデアを形にできます
求める結果を説明するだけで、Fableが実現方法を導き出します
複数のステップにわたる長期プロジェクトを、より少ない確認で完了できます
下には、「Fable 5.2を試す」と「後で」の2つのボタンがあります。「50%」の文はプランによって意味が変わるので、気をつけたい点の節で触れます。できることの3つの文は、公式の説明と見比べてみます。
アニメと3Dの話
Anthropicの製品ページには、Fable 5.2は画面の中のものも現実の物もデザインするのが得意で、3Dの世界やシミュレーション、アニメーションをコードで作れる、という説明があります(Fableの製品ページ。※英語サイト・自動翻訳推奨)。「アニメーション、シミュレーション、3Dワールド」の文と同じ方向の話です。
アニメや3Dそのものを測った点数は、発表にはありません。近い分野だと、部品の設計を測るBenchCADと、ロボットの操作を測るRoboDojoがあって、どちらも5.1から大きく伸びた項目です。出来栄えがどうなのかは、自分の目で見るのが手っ取り早いです。
任せ方の話
「説明するだけで」の文に近い例として、発表では、回路基板の設計や使う部品の選び方まで、AIに任せた話が紹介されています。
結果を伝えて任せる使い方なら、ClaudeのCowork(フォルダを指定して、ほしい成果物を頼む機能。出版社の紹介による)を解説した本も出ています。Fable 5.2の話ではなく、Claudeで任せる使い方の本ですが、2026年8月の発売で、楽天ブックスでは2,882円でした(11月9日時点)。

長期プロジェクトのデモ
「複数のステップにわたる長期プロジェクト」の文に近い例として、Anthropicの公式チャンネルが、OS(パソコンを動かす基本のソフト)を一から作らせたというデモ動画を公開しています。
公式が選んだデモなので、同じことが誰にでもできるとは限りません。公式は、このデモを発表ページに選んで載せています。
5.1から変わったところ
値段と速さ
API(アプリやプログラムからAIを使うときの窓口)の料金は、100万トークン(AIが読み書きする文字の量の単位)あたりで決まっています。2026年11月9日時点で、Fable 5.2は5.1より2割安く、Opus 5.5と比べると2倍です。
| モデル | 入力 | 出力 | 条件(料金は100万トークンあたり) |
|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | 高速モードは入力$16・出力$80。公式は最大2.5倍速としている |
| Claude Fable 5.1 | $10 | $50 | ― |
| Claude Opus 5.5 | $4 | $20 | ― |
| GPT-6 Astra | $10 | $50 | 272Kトークン未満の標準料金(OpenAIの料金ページ) |
| Gemini 4 Argon | $2 → $4 | $10 → $20 | 2026年11月30日まで$2・$10。12月1日から$4・$20(Googleの料金ページ) |
速さについて、Anthropicは、5.2は5.1より出力が最大30%速いと書いています。これはテスターが見つけたこととして書かれていて、Anthropicの測定値ではありません。高速モードなら最大2.5倍速くなる、ともAnthropicは書いています。
5.1とOpus 5.5を料金で比べた記事は、こちらです。
テストの点数の変化
Anthropicが発表した比較表には、5.1と5.2の点数がずらりと並んでいます。発表したのも、表に載せる評価を選んだのもAnthropicで、一部の行はCognition社やScale AIなど外部の会社が測っています。どれも第三者が確かめた値ではなく、Anthropicの自己申告です。ソフト開発に近い10の結果では、5.2のほうが高いのが9つ、低いのが1つ(ProgramBench)でした。次の図の青い棒が5.1、赤い棒が5.2で、テストの名前は全部読まなくて大丈夫です。
※1〜※3の注と、数字の出どころの説明(押すと開きます)
グラフのCursorBenchは、5.2の点の一部が、指示文とAIを動かす周りの仕組み(ハーネス)の改善によるもの、とCursor社が説明している、とAnthropicの資料にあります。この行は割り引いて読むものです。
グラフに入っていない6つのテストは、6つとも5.2のほうが高い結果でした。下の表は、条件や注を細かく見たい人のためのものです。上から、知識、図の読み取り、設計、ロボット、仕事、パソコン操作のテストの順です。
| テスト(何を測るか) | 5.1 | 5.2 | 伸び(点) | 条件・補足 |
|---|---|---|---|---|
| いろいろな分野の難問の試験(ツールなし) Humanity’s Last Exam | 60.9% | 73.2% | +12.3 | ― |
| グラフや図の読み取り(ツールなし) Chartography | 44.8% | 73.4% | +28.6 | 公開されている図が元で、記憶で答えている可能性がある(表の下の注) |
| 部品や機器の設計 BenchCAD 2.1 | 44.4点 | 83.5点 | +39.1 | Opus 5.5は65.3点 |
| ロボットを操作する成功率 RoboDojo Sim | 27.6% | 64.9% | +37.3 | maxで、Anthropicが社内で実行した結果。第三者の再現ではない |
| フリーランス案件の自動化率 Remote Labor Index | 17.9% | 41.3% | +23.4 | Scale AIが実行。既定のHigh、文脈は20万トークン。5.2は240件中99件 |
| パソコンの操作(オフライン・部分点) OSWorld 2.1 | 83.5% | 89.3% | +5.8 | ― |
- Chartographyは、公開されている図が元になった問題が多く、5.2は元のデータを記憶していて答えられる質問がある可能性があります。Anthropicは、図を描き直す検査で影響は小さいとしていますが、完全には示せないとも書いています。
- GDPval-AAなどのElo(勝負した相手の顔ぶれで動く相対的な点数)は、グラフにも表にも入れていません。5.1の値が、5.1の発表のときは1853、今回の資料では1763と、版によって違うからです。どれだけ上がったとは言えません。
こうして並べると、コーディングに関わる項目が目立ちます。Claude Codeを触ったことがなければ、遠い話に聞こえるかもしれません。Claude Codeの入門書が、8月14日に出ています。楽天ブックスで3,300円でした(11月9日時点)。

Astra・Argonと並べると
第三者の物差しでは
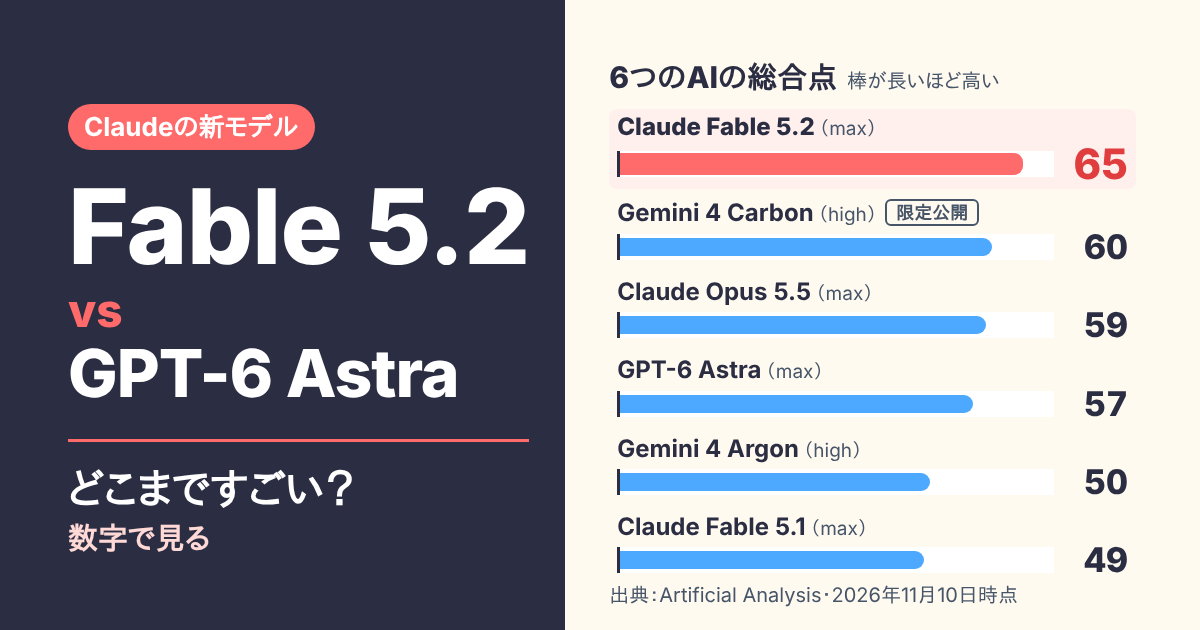
公式の表は各社が自分で選んだものなので、同じ物差しで測っている第三者の数字がありがたいです。Artificial Analysis(以下AA)の総合点(正式名はIntelligence Index v5.0.1)で並べると、2026年11月10日3:29(UTC。日本時間では12:29)時点で、Fable 5.2(最大の設定)が65点で1位でした。5.1は49点で、同じ物差しで16点上がっています(AAのモデル一覧。※英語サイト・自動翻訳推奨)。
棒の横のmaxとhighは、エフォート(AIにどれだけ考えさせるかの設定。図では「考えさせる深さ」と書いています)の違いです。同じ設定ではないので、棒の高さをそのまま並べて読むのは少し乱暴です。限定公開のCarbonはAAの表に載っていますが、測り方の説明はAAのページに見当たらないままです。AAの数字も、測るテストと条件はAAが決めたものなので、1つの物差しとして読むのが安全です。
考えさせる深さ(エフォート)による違いは、こちらの記事でも扱っています。
各社の表を横に並べる
次は、各社が公表している点数のうち、Fable 5.2とAstra・Argonが同じ名前のテストで並ぶものです。Carbonの列はAnthropicの表にある値で、限定公開のモデルのため、第三者が確かめることもできません。黄色の欄は、その行でいちばん高い値で、Fable 5.2ではない欄が黄色の行もあります。
| テスト | Fable 5.2 | GPT-6 Astra | Gemini 4 Argon | Gemini 4 Carbon 限定公開 |
出どころ |
|---|---|---|---|---|---|
| FrontierCode 2.0 実在するオープンソースの変更 | 49.1% xhigh | 42.8% max | ― | 41.1% Medium | Anthropicの表。考えさせる深さ(エフォート)は各モデルの最高点が出たもの |
| FrontierSWE v2 超長時間のエンジニアリング | 69.9% | 65.5% | 55.0% | 61.2% | Fable・Astra・Argonはシステムカード。Carbonの値はAnthropicの表だけ |
| DeepSWE v1.1 長いソフト開発の課題 | 74.3% | 74.1% | 77.9% | ― | Fableはシステムカード、AstraとArgonはGoogleのモデルカード(Fable 5.2の発売前の表) |
| Terminal-Bench-Science 0.1 科学研究のターミナル作業 | 74.6% | 68.1% | 57.6% | 64.8% | Fableはシステムカード、AstraはOpenAIの報告値、ArgonはGoogleの表、CarbonはAnthropicの表 |
| AutomationBench 業務の自動化 | 51.4% | 41.4% | 51.3% | 53.9% | Fable・Astra・CarbonはAnthropicの表、ArgonはGoogleの発表 |
| Chartography(ツールなし) グラフや図の読み取り | 73.4% | 71.0% | 71.6% | 72.5% | Fableはシステムカード、AstraとArgonはSurge AIの公開値、CarbonはAnthropicの表 |
| Humanity’s Last Exam(ツールあり) 難問の試験 | 74.2% | 57.2% | ― | ― | システムカードの表 |
| Remote Labor Index フリーランス案件の自動化率 | 41.3% | 20.8% | ― | ― | システムカードの表。Scale AIが実行 |
| RoboDojo Sim ロボットを操作する成功率 | 64.9% max | 29.8% max | 34.2% High | ― | Anthropicが社内で実行。ArgonだけHigh |
Gemini 4 Argonと、GPT-6、Claudeを並べた記事は、こちらです。
気をつけて読みたい点
1つの仕事にかかる費用
単価だけを見ると、Fable 5.2はAstraより安く見えます。ところがAAが測った、AIが問題を1つ解くときのお金は、最大の設定(max)で、Fable 5.2が26.54ドル、Opus 5.5が10.04ドル、Astraが6.24ドルです。Opus 5.5の約2.6倍、Astraの約4.3倍になります。このお金は、月額のアプリで払う額ではなく、APIの料金で計算した額です。AAが総合点を測るあいだにFable 5.2が書き出した文字(トークン)は2億7,500万で、中央値の7,280万を大きく上回りました。次の図には、同じAIが設定を変えて、maxの組とhighの組に1回ずつ出てきます。
棒の右端=30ドル
棒の右端=50分
棒の右端=30ドル
棒の右端=50分
測った日時と、数字が変わることの説明(押すと開きます)
見積もった時間も同じ向きで、maxで測るとFable 5.2はOpus 5.5の約1.8倍、Astraの約2倍です(AAが計算した見積もりで、実際に計った時間ではありません)。Anthropicが書いている最大30%速いという話は、5.1との比較で、テスターの報告です。文字を出す速さと、問題を1つ解き終えるまでの時間は別の話なので、並べて読まないほうが安全です。
Fable 5.2に考えさせる深さは、浅い順に、低め(low)・ふつう(medium)・高め(high)・とても高め(xhigh)・最大(max)の5段あります。highなら総合点は62で、maxより3点低く、お金は9.08ドルとmaxの3分の1ほどです。
棒の右端=30ドル
棒の右端=50分
他のAIの参考数字と、測った日時などの説明(押すと開きます)
Anthropicの側から見ると、費用の別の見え方もあります。Cognition社が測ったFrontierCodeでは、考えさせる深さをHighにした5.2が45.3%で、Opus 5.5の最高点の45.5%とほぼ同じ。課題1つあたりの費用は6.72ドルと12.82ドルで、約半分でした(上の図のhighはAAの測定で、別の物差しです)。ただ、初期のテストの結果で、1回の結果のため、誤差の幅は出ていません。
Opus 5.5と並べると
Anthropicは、システムカード(モデルの性能と安全性をまとめた公式の資料)の表で報告した16の結果のうち、14でFable 5.2が最高だったと書いています。残る2つ、GDPval-AA(実際の仕事に近い課題)とAA-BriefcaseのEloでは、Opus 5.5が上でした。GDPval-AAはOpus 5.5が1866、Fable 5.2が1831です(システムカード。※英語サイト・自動翻訳推奨)。
この16の表は、Anthropicが選んだ評価だけです。資料自身も、全部の結果にはFable 5.2が最高ではないものも含まれる、と断っています。発表の脚注には、外部の団体は発表文もシステムカードの中身も確認していない、とあります。AnthropicもOpus 5.5から始めるよう勧めているので、全部の仕事でFableを使えばいい、という話ではないようです。
比べにくい点
- 考えさせる深さが揃っていない。行によって、モデルごとの設定(エフォート)が違います。FrontierCodeは、Fable 5.2がxhigh、Astraがmax、CarbonがMediumでした。Fable 5.2は、maxよりxhighのほうが高い点でした(49.1%と45.7%)。
- テストの版が違う。OSWorldは、Anthropicが2.1、GoogleとOpenAIが2.0を使っています。別の版なので、同じ行には並べていません。
- 同じ名前の行でも、出どころで値が違う。Terminal-Bench 4.0のFable 5.1は、Anthropicのシステムカードで55.8%、Googleのモデルカードでは57.9%でした。Anthropicの表のOpus 5.5はxhighの値で、Fable 5.2のmaxとは条件が違います。
Fableの安全装置の切り替え
Fable 5.2には、サイバー攻撃にかかわる危ない作業や、生物の研究の作業の大半を止める安全装置がついていて、止めた作業には、サイバーならOpus 4.8、生物ならOpus 5が代わりに答えます。Anthropicの初期テストでは、5.1より誤って止める回数が約55%減ったそうです。
Anthropicの表も、AAの測定も、この安全装置が働く状態の点です。他社のモデルの点は、同じ条件ではありません。サイバーや生物の研究に近い作業では、答えているのがFableではない場面もある、ということです。
Claudeの週間使用量の50%
告知画面の「週間使用量の50%を上限としてプランに含まれています」は、プランによって意味が違います。自分のプランがどちらに当たるかで、読み方が変わります(プランのヘルプと発売記念のヘルプ。※どちらも英語サイト・自動翻訳推奨)。
- Max・Ultra・Teamのプレミアム席(席型Enterpriseのプレミアム席も):Fableはプランの標準の一部で、週間使用量の50%までを追加料金なしで使えます。使用量の上限が増えるわけではなく、ほかのモデルと同じ上限を分け合います。50%を超えたら、使用量クレジット(別の従量課金)でFableを続けるか、別のモデルに切り替えます。
- ProとTeamの標準席:発売記念の期間限定で、11月9日から米国太平洋時間の11月16日23:59(日本時間では17日の夕方)まで、50%まで含まれます。期間が終わると、Fableは使用量クレジット払いに戻り、使い切れなかった50%は繰り越されません。
Fableは、ほかのClaudeモデルより使用量が速く減る、と公式のヘルプに書いてあります。何倍速く減るかの数字は出ていません。以前にもFable 5で「50%」の販促があり、2026年7月19日に終わっていますが、今回とは別のものです。使用量の減り方を扱った記事は、こちらです。
試すときに見たい点
告知画面の3つの文と、ここまでの数字から、触るときに目を向けたいところを挙げてみます。
- アニメや3Dが、どこまで形になって出てくるか
- 結果だけを説明して、確認で止まらずに最後まで進むか
- 考えさせる深さを上げ下げしたとき、出来と待ち時間がどう変わるか
- 1回の作業で、週間使用量がどれだけ減るか
指示の出し方やAIとの付き合い方を、もう少し知っておきたい人には、Claudeを使い込んだ事例の本があります。日経BPの『Claude活用大全』は2026年8月の発売で、出版社の紹介では、ほかのAIと比べたClaudeの使い勝手が気になる人もおすすめの読者に挙げています。楽天ブックスで2,860円でした(11月9日時点)。

まとめ
数字の上では、期待できるモデルです。AAの測定でも1位で、5.1からの伸びも大きく見えます。一方で、1つの仕事にかかる費用と時間は大きく、Opus 5.5に負ける項目も、比べにくい条件もありました。
- すごい点:第三者のAAの総合点で1位。5.1からの伸びも大きい。
- 注意する点:1つの仕事にかかる費用と時間が大きい。Opus 5.5に負ける行がある。点数の条件が揃っていない。
- 使うとき:有料プランで選べます。画面の「50%」は、プランによって意味が違います。
画面の「Fable 5.2を試す」のボタンは、もう目の前にあります。期待は大きいまま、ここまで見てきた数字が実際の使い心地とどう重なるのか、これから試します。
コメント