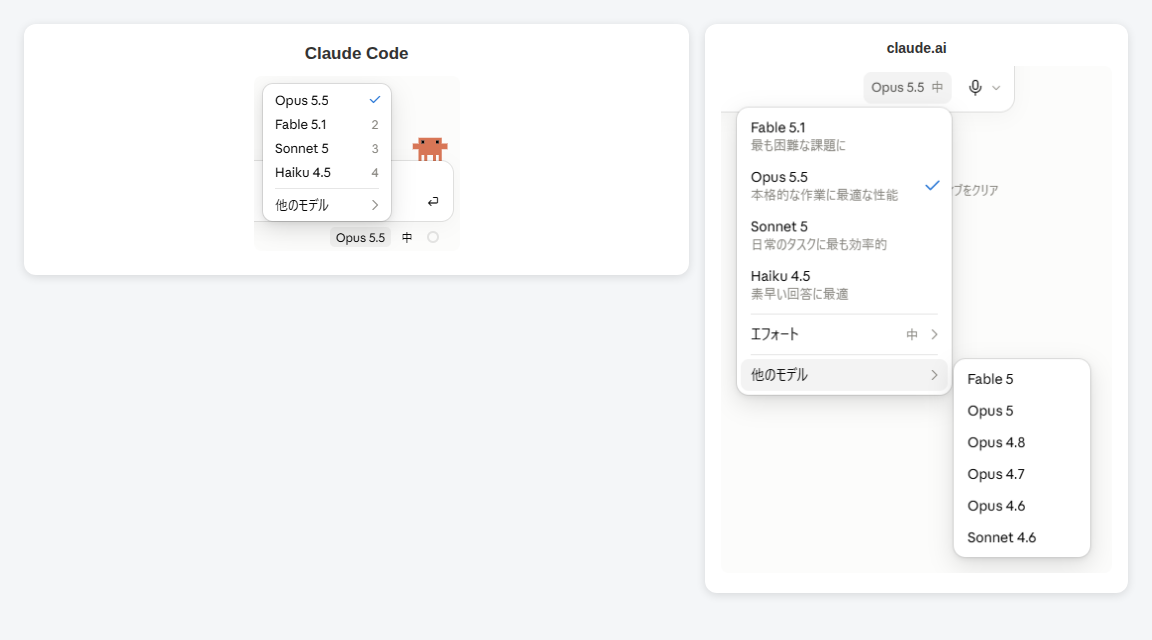
ぼく(あんちゃん)が使っているClaude Codeのモデル選択画面。いちばん上に並んでいたのは「Opus 5.5」でした。「Fable 5.1」はその下です。これって、Opus 5.5のほうが上位のモデルってことなんでしょうか。今回はこの疑問を出発点に、いま使えるClaudeのモデルを料金つきで整理してみます。
きっかけになったのは、この発表です。
Claudeのモデル比較。Opus 5.5とFable 5.1、なぜ並び順が違うのか
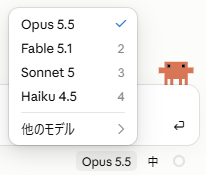
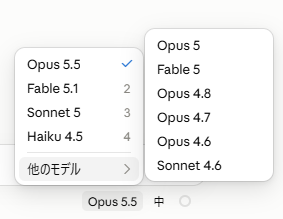
ぼくが普段使っているClaude Codeのモデル選択画面では、上から「Opus 5.5(選択中)」「Fable 5.1」「Sonnet 5」「Haiku 4.5」の順に並んでいて、いちばん下に「他のモデル」という項目があります。開いてみると、そこにはOpus 5・Fable 5・Opus 4.8・Opus 4.7・Opus 4.6・Sonnet 4.6が入っていました。
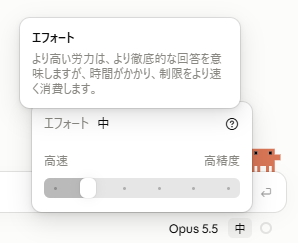
もうひとつ、画面の下のほうには「エフォート」という項目もあって、表示は「中」のままでした。エフォートというのは、モデルがどれくらい念入りに考えるかの設定です。押すと、こんな説明とスライダーが出てきます。
ところが、claude.aiの通常のチャット画面を開くと、並び順が違うんです。上から「Fable 5.1(最も困難な課題に)」「Opus 5.5(本格的な作業に最適な性能)」「Sonnet 5(日常のタスクに最も効率的)」「Haiku 4.5(素早い回答に最適)」でした。こちらはFable 5.1のほうが上に出ています。
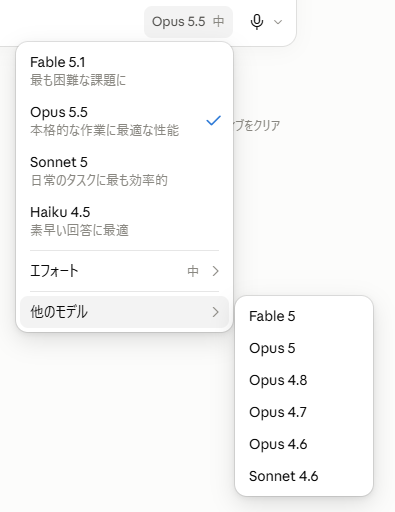
同じ会社の同じモデルのはずなのに、アプリによって並びが逆なんですよね。これだけ見ると「結局どっちが上位なんだ」と迷ってしまいます。Anthropicのモデル一覧のページやOpus 5.5の発表文もひととおり見てみたんですが、この並び順そのものについて説明している記述は見つけられませんでした。
ただ、Anthropic自身のモデル比較ページには、こう書かれています。「迷ったらまずOpus 5.5を使ってください。手強い推論や長時間のエージェント作業、あるいはOpus 5.5でエフォートを上げても物足りないときはFable 5.1を」(英語の原文をぼくが訳しました。「エージェント作業」は、Claudeが自分でファイルを読んだりコマンドを実行したりしながら、複数の手順をこなす作業のことです)。この言葉をヒントにすると、上下の並びは性能の優劣を表しているわけではなく、「まず試してほしいモデル」が上に来ているだけなのかもしれません。あくまでぼくの推測です。並び順の話は、性能そのものとは切り離して読んでくださいね(性能の実測値は次の章で見ていきます)。

ここからは、今回の主役であるOpus 5.5そのものについて、もう少し詳しく見ていきます。
Opus 5.5って結局なに? Fable 5.1並みの性能で4割安いらしい
「4割安い」の中身は、値下げだけじゃなかった
Anthropicの発表文(英語サイト・自動翻訳推奨)には、こう書かれています。「多くの作業でFable 5.1と同水準の性能を持ちながら、Opus 5より40%安く動かせる」(英語の原文をぼくが訳しました)。じゃあ単純に値段が4割下がったのかというと、ちょっと違いました。
ITmediaの記事によると、値下げの中身はこうです。API料金そのものは、入力・出力ともにOpus 5より20%の値下げ(入力は100万トークンあたり4ドル、出力は20ドル)。トークンというのは、AIが文章を処理するときの文字のかたまりの単位で、日本語だと1文字が1〜2トークンくらいになることが多いです。コーディングやエージェント作業でコストの大半を占める「キャッシュ読み込み」(一度読ませた指示や資料を、次のやり取りでもう一度読み直すときの処理。まっさらに読むより安く済みます)は、100万トークンあたり0.2ドルまで60%引き下げられました。この20%の値下げと60%のキャッシュ引き下げに、使うトークン数そのものが減った効果も合わさって、「既定の設定で一般的なワークロードを処理した場合」のコストがOpus 5より40%低くなる、という計算のようです。つまり「4割安い」は単価の話だけでなく、実際の使われ方まで含めた見積もりだということですね。出力の速さもOpus 5より30%以上速いそうです。
ベンチマークの数字も見ておきます
Anthropicの発表資料に載っていたベンチマークの数字を、そのまま並べておきます。「Terminal-Bench 4.0」というコーディング寄りのテストでは、Opus 5.5が66.4%、Fable 5.1が55.8%、前世代のOpus 5が52.3%でした。10.6ポイントの差なので、これははっきりOpus 5.5が上です。「Humanity’s Last Exam」という幅広い分野の推論力を測るテスト(ツールを使える条件での数字)では、Opus 5.5が67.7%、Fable 5.1が65.6%でした。「Fable 5.1並み」というより「実測ではFable 5.1より上」に見えます。ただし注記があって、Opus 5.5の数字は「特に断りがない限り、アダプティブシンキングを最大エフォートで測った結果」とのことです。Terminal-Bench 4.0にいたっては、最大の1つ手前の「xhigh」という設定で測っているそうで、Anthropic自身も「実際に使ってみると、この点差ほどの差は感じない」(英語の原文をぼくが訳しました)と書いていました。ふだんの設定(エフォート「中」)では、ここまでの差にはならないかもしれません。
早期テスターの話も面白かったです
発表文には、テストに参加した人たちの話も載っていました。あるテスターは68万行のコード移行を1日足らずで終えたそうです。社内テストでは、ロードバランサーのソフト「HAProxy」をC言語からRustに書き換える作業を、Fable 5.1より短い9.5時間で終え、コストは51%少なかったとのことでした。数字だけ聞くとピンと来にくいですが、ふだんパソコンで何時間もかかる作業を思い浮かべると、けっこう大きな差ですよね。

さて、次はいよいよ肝心の料金を見ていきましょう。
料金を一覧にしてみました
ここからは料金です。数字は2026年9月23日に、Anthropicの公式の料金ページ(英語サイト・自動翻訳推奨)から拾ってきました。基本の入力・出力に加えて、さっき出てきた「キャッシュ読み込み」(前の指示や資料を読み直すときの、割安な処理)の値段も並べています。
※MTokは「100万トークン」の略です。金額はすべて米ドルで、Anthropicの公式ページ(platform.claude.com)に2026年9月23日時点で載っていた数字です。
表を見て分かるとおり、いちばん高いのはFable 5.1で、いちばん安いのはHaiku 4.5です。今回主役のOpus 5.5は、値段だけ見るとFable 5.1のちょうど5分の2くらいで、旧世代のOpus 5よりも安くなっています。
もう一つ、コスト面で見逃せないのが「Batch API」と「Fast mode」です。Batch APIは、急ぎじゃない処理をまとめて送ると入力・出力とも半額になる仕組みで、Opus 5.5なら入力2ドル・出力10ドルまで下がります。逆に「Fast mode」は、最大2.5倍の速さで返してくれる代わりに割高になる仕組みで、Opus 5.5は入力8ドル・出力40ドルでした。「急がないなら半額」「急ぐなら割増し」という、分かりやすい二択になっています。
1回のやり取り(入力8,000・出力4,000トークン)でいくらになるか計算してみた
料金表を見ても、正直ピンと来ないですよね。なので、指示や参考資料を含む入力が8,000トークン、返ってくる本文の出力が4,000トークン、という1回のやり取りを想定して計算してみました。このトークン数はぼくが決めた目安で、実際のやり取りはこれより多いことも少ないこともあります。為替レートは、2026年9月23日13時時点の東京外国為替市場の速報(共同通信配信)によると1ドル157円67銭〜68銭だったので、分かりやすく1ドル=158円で計算しています。
※計算式:入力8,000トークン÷100万×入力単価+出力4,000トークン÷100万×出力単価。1ドル158円換算。Opus 5.5はFable 5.1の半分よりさらに安く、Fable 5.1と比べると約4割の値段で済む計算になりました。
ただし、この金額は「出力4,000トークンぶん、そのまま答えが返ってきた場合」の話です。Opus 5.5とFable 5.1は「アダプティブシンキング」という、モデルが自分で考える量を決める方式になっていて、手動でオフにはできません(公式ドキュメントの原文で確認!!)。考えた分のトークンも出力トークンとして課金されるので、実際にはこの表より高くなることがあります。簡単なやり取りなら考える量は少なめで済むようですが、込み入った質問をするほど、この概算より上振れすると考えておいたほうがよさそうです。
もちろんこれは1回のやり取りの目安で、実際は下書きを直したり質問を重ねたりするので、もっとやり取りが増えます。それでも「どのモデルも1回のやり取りなら数円〜数十円の世界」という感覚はつかめたんじゃないでしょうか。Fable 5.1とOpus 5.5の差は、1回だけならコーヒー1杯にも満たない金額ですが、毎日何十回もコードを書かせる使い方だと、じわじわ効いてきそうです。
どのプランで、どのモデルが使えるのか
ここまでの料金はAPI(開発者向けの従量課金)の話でした。ぼくたちがふだん使うアプリ版のClaudeは、Free・Pro・Maxというサブスクリプションのプランになっていて、話がちょっと違います。claude.com(Anthropicの公式サイト)の料金ページを見てみると、こうなっていました。
※Freeプラン(無料)はSonnetとHaikuだけで、Fable・Opusは使えません。Proは月額20ドル(年払いだと月あたり17ドル相当)、Maxは月額100ドルからです。どのモデルにも無制限に使える保証はなく、Anthropicの発表文には「Pro・Max・Team・シート制のEnterpriseで5時間ごとの利用上限を引き上げた」とあります(つまり元から利用上限は存在していて、それを広げたということです)。そのうえでFable 5.1だけは、公式ページにこう書かれています。「Claude Fableモデルは、Max planに週間使用量の上限の50%まで含まれています。Proユーザーは使用クレジットでFableにアクセスできます。」使用クレジットというのは、上限を超えたぶんを標準のAPIレート(さっきの料金表の金額)で追加払いする仕組みです。つまりProでFable 5.1を使うと、上の「1回のやり取りでいくらか」の表にあった金額が、そのまま追加のお財布から出ていくイメージです。
無料版とProの違いをもう少し詳しく知りたい方は、こちらの記事にもまとめています。

「エフォート」という言葉が気になった方は、この設定について詳しく書いた記事もあります。
結局、どれを選べばいいのか。ぼくなりの整理
ここまでの数字を踏まえて、ぼくなりに整理してみました。正解は人によって違うと思うので、目安として読んでもらえたらと思います。
- ふだんの調べものや文章の下書きなど、日常づかいが中心なら:Sonnet 5。速さと賢さのバランスが良く、値段も手ごろです。
- コードを書かせる作業が多く、コストも気になるなら:Opus 5.5。Fable 5.1に近い、もしくはそれ以上の性能を、より安い値段で使えます。
- 腰を据えて難しい設計や長時間のエージェント作業をやらせたい、Opus 5.5で物足りなかったときの奥の手として:Fable 5.1。Maxプランでは週の利用枠の50%までという別枠、Proプランでは使用クレジットの追加払いになるので、使いすぎには注意です。
- とにかく素早い返事だけでよい、ちょっとした一問一答なら:Haiku 4.5。ここまでの4モデルの中では料金がいちばん安いです。
プラン選びの面でも整理しておきますね。Freeプランで使えるのはSonnetとHaikuだけ、Opus 5.5を使いたいならPro以上、Fable 5.1はMaxの利用枠に含まれるか、Proなら追加料金を払って使う形になります。
ぼく自身は、まだOpus 5.5とFable 5.1を使い比べてはいません。今回は発表と公式ページの数字を整理しただけなので、実際に触ってみた感触はまた別の記事で書きますね。

まとめ:並び順は目印。選ぶ基準は自分の使い方
Claude Codeとclaude.aiでOpus 5.5とFable 5.1の並びが逆になっていた件、はっきりした答えは公式には見つけられませんでした。ただ、公式のモデル比較ページの言葉をヒントにすると、「上に出ている=偉い」ではなく、「まず試してほしいモデル」が上にきているだけ、という見方もできそうです。性能で見ればOpus 5.5はむしろFable 5.1を上回るベンチマークも多く、値段はFable 5.1よりずっと安いモデルです。並び順に振り回されず、自分の使い方に合わせて選ぶのがいちばんだと思います。
Opus 5が発表されたときの記事もあわせてどうぞ。スマホでモデルを選ぶ手順を、実際の画面で紹介しています。
Claude Codeをまだ触ったことがない方には、非エンジニア向けの入門記事もおすすめです。
コメント